返回文章列表

Blender AI建模选哪家?用37道题测出4家AI的真实能力

王冲发布于2026年11月6日
返回文章列表

Blender AI建模选哪家?用37道题测出4家AI的真实能力

王冲发布于2026年11月6日
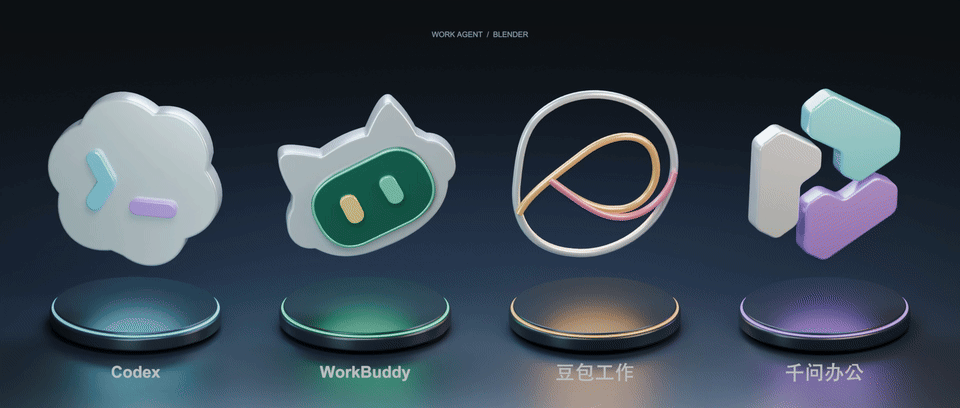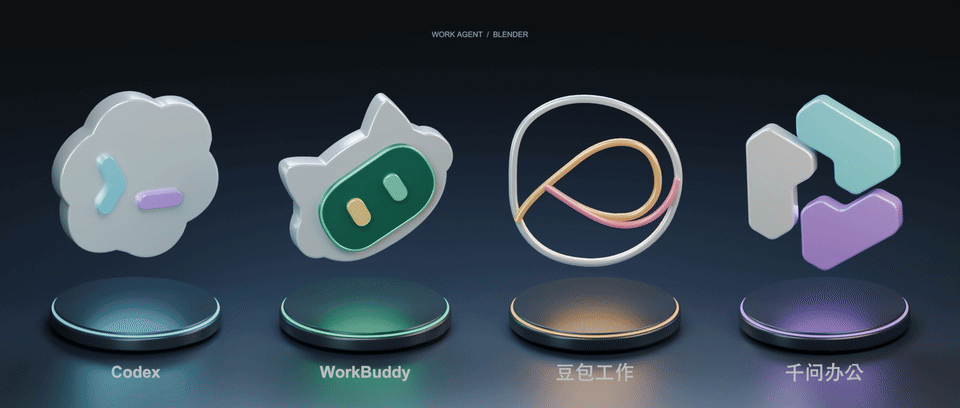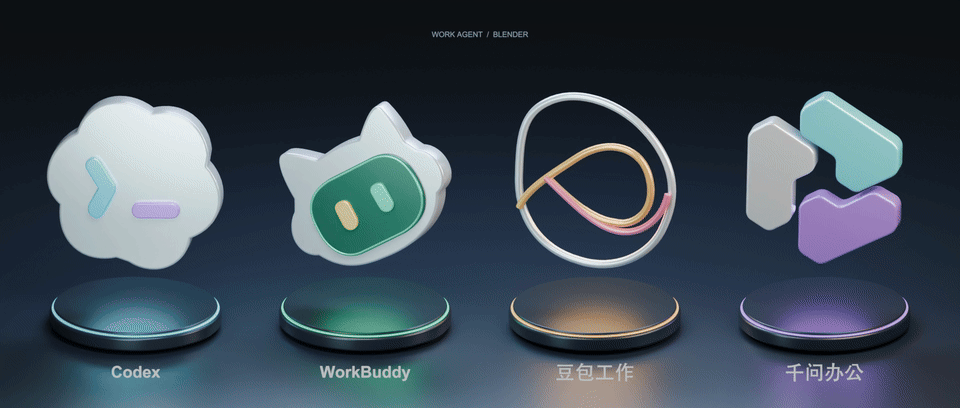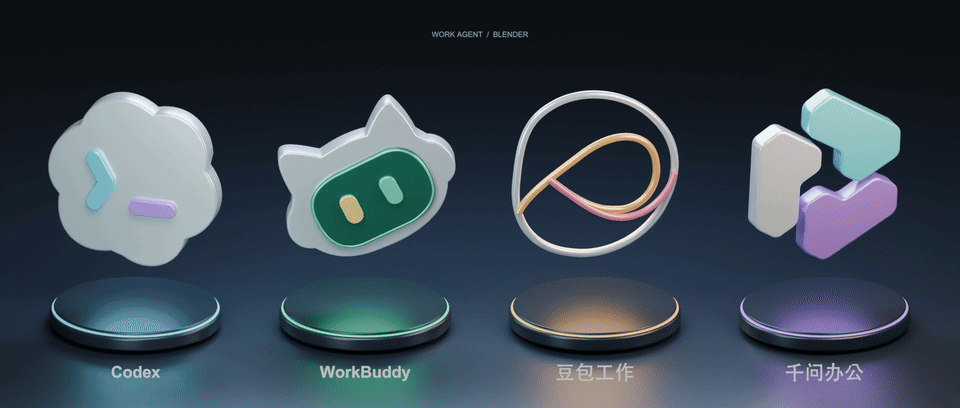
Blender 评测中的四款 Work Agent:Codex、WorkBuddy、豆包工作、千问办公

上一期,我们比较了 Codex、WorkBuddy、豆包工作和千问办公在 AutoCAD 中的实际交付。这一期,我们继续聚焦工业场景,把考场搬到 Blender,看看这四款 Work Agent 在三维建模与动画任务中的表现。

我们都测试了什么

我们邀请了 8 位行业专家,共准备了 37 道题目。我们既看模型与动画是否符合要求,也检查交付的工程文件能否让人接着修改和使用。
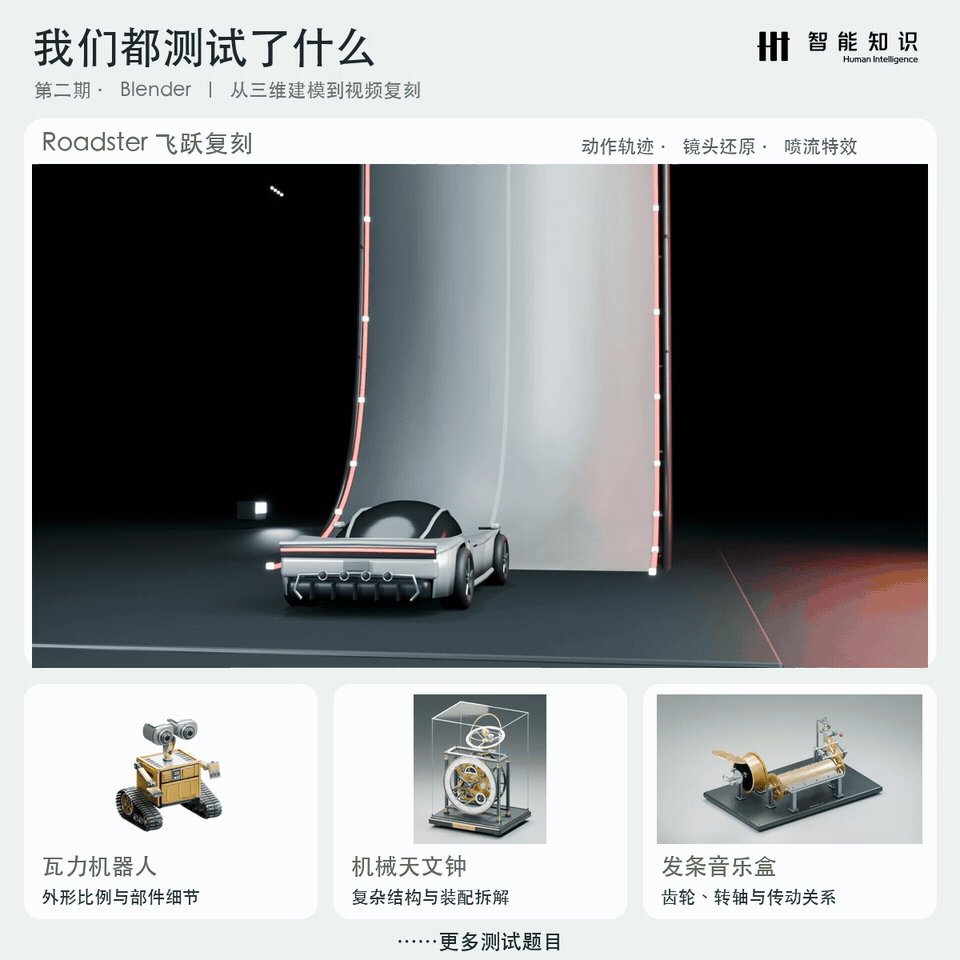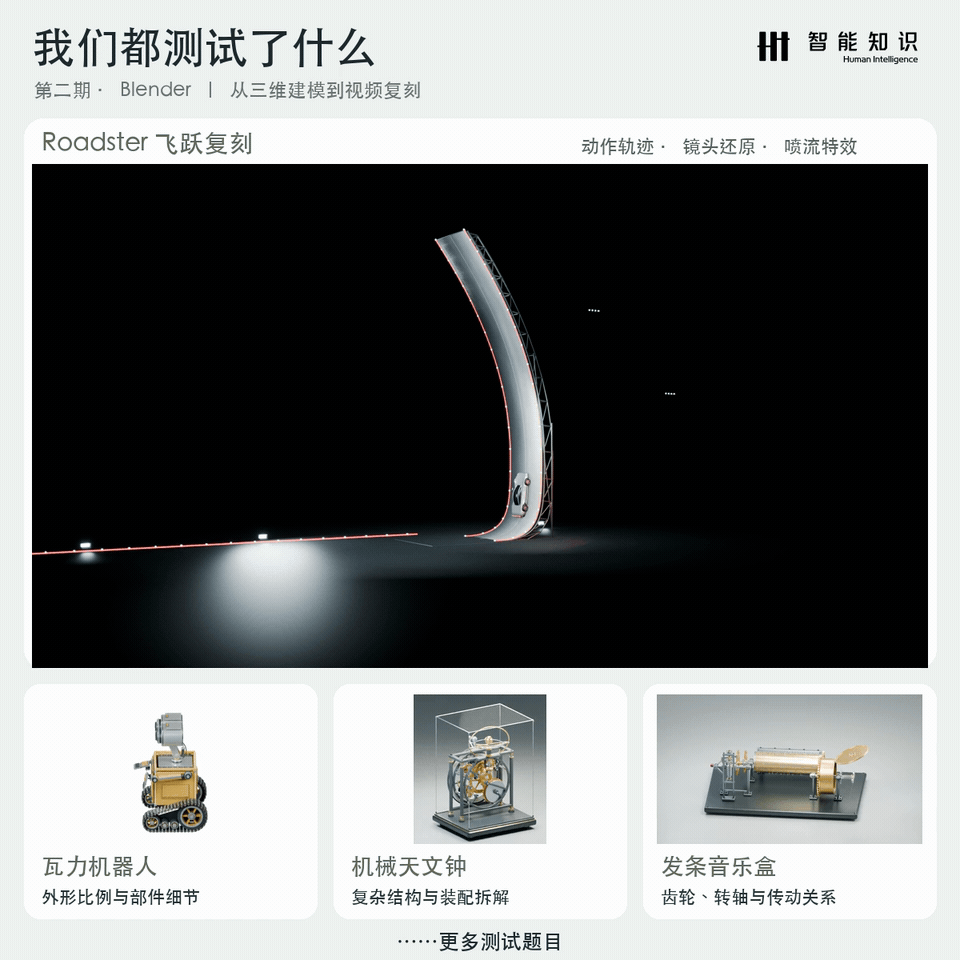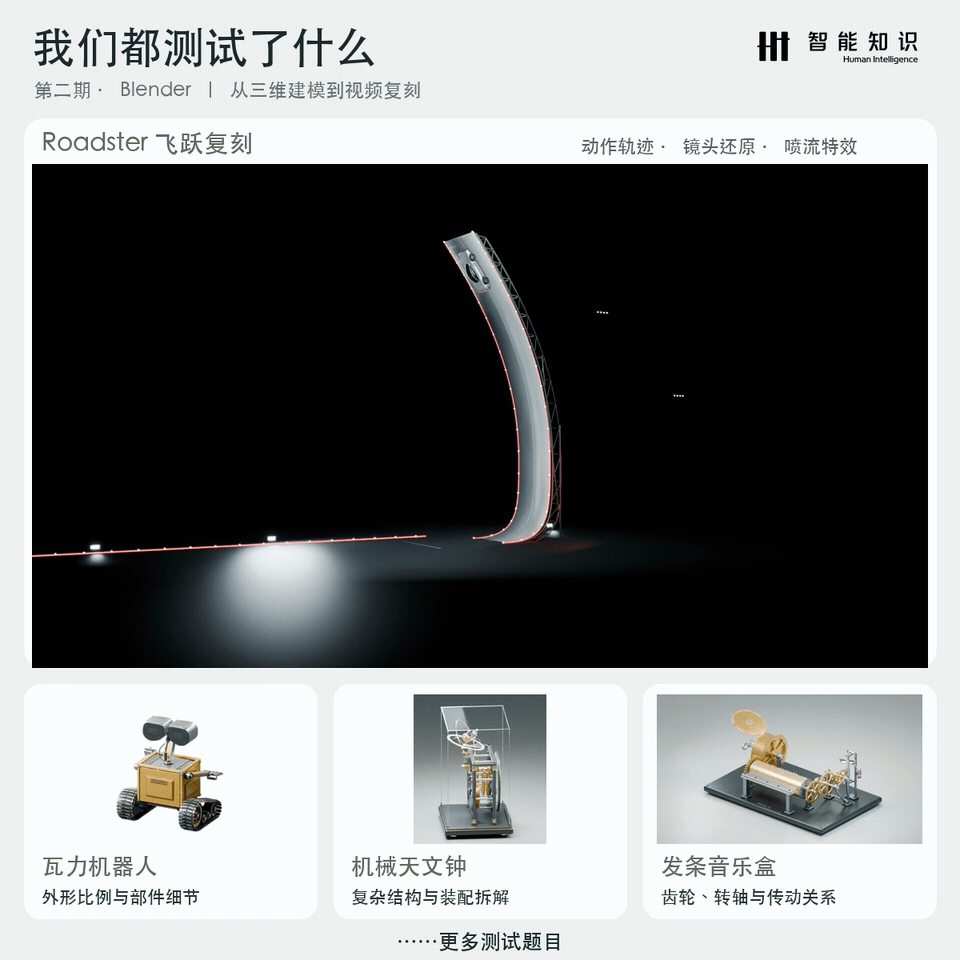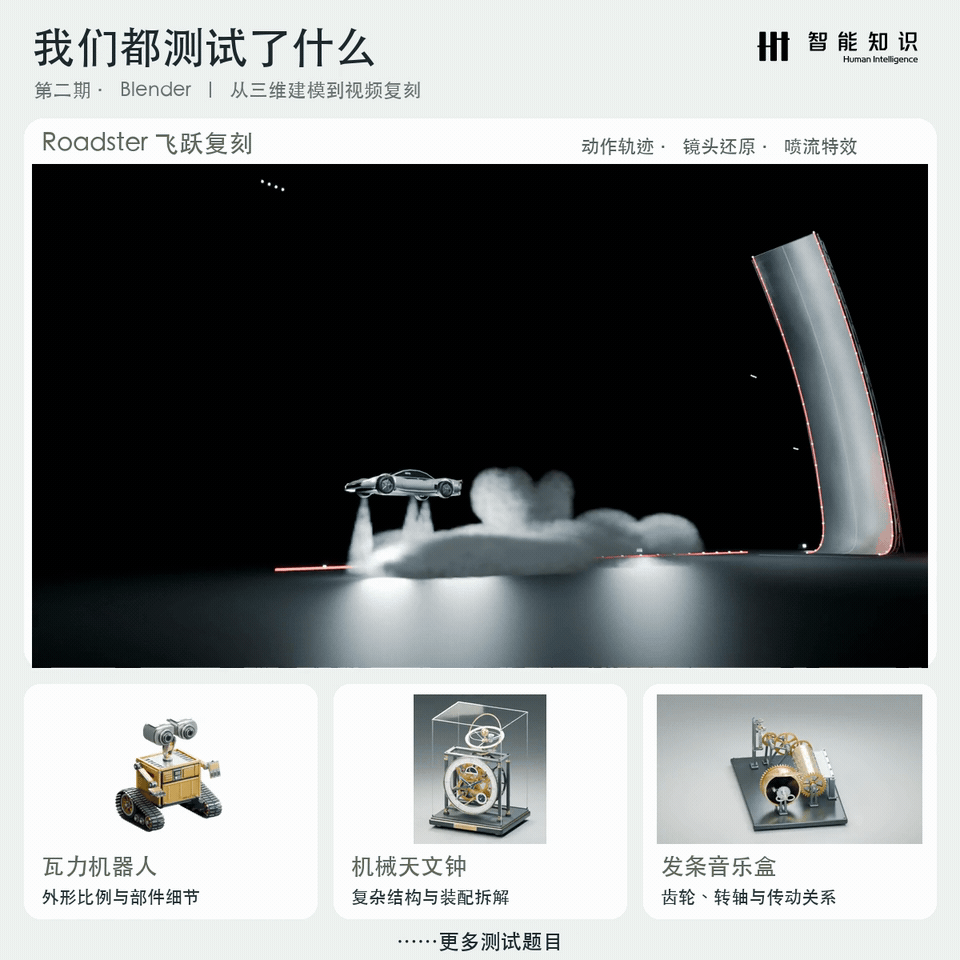
我们都测试了什么:Roadster 飞跃复刻、瓦力机器人、机械天文钟、发条音乐盒等题目

本篇主要介绍其他 36 道题,其中《Roadster 飞跃复刻》的详细过程,欢迎查看《最强 Agent,能否复原出特斯拉飞行汽车?》,了解 4 家 AI Agent 详细复刻过程和最终效果。

成绩与能力差异:谁领先,优势在哪里?

综合本轮评估结果,**Codex 以 96.8 分领先,WorkBuddy 为 72.4 分,豆包工作为 70.7 分,千问办公为 66.6 分。**Codex 在五个维度上的均分均为最高;其余三家各有短板,其中 WorkBuddy 的展示表达较好,豆包工作的功能与空间关系得分略高。四家的可编辑性都达到 90 分及以上,真正拉开差距的,更多是几何细节、结构关系,以及模型和展示能否一致地落实要求。

五个维度分别表现怎样?
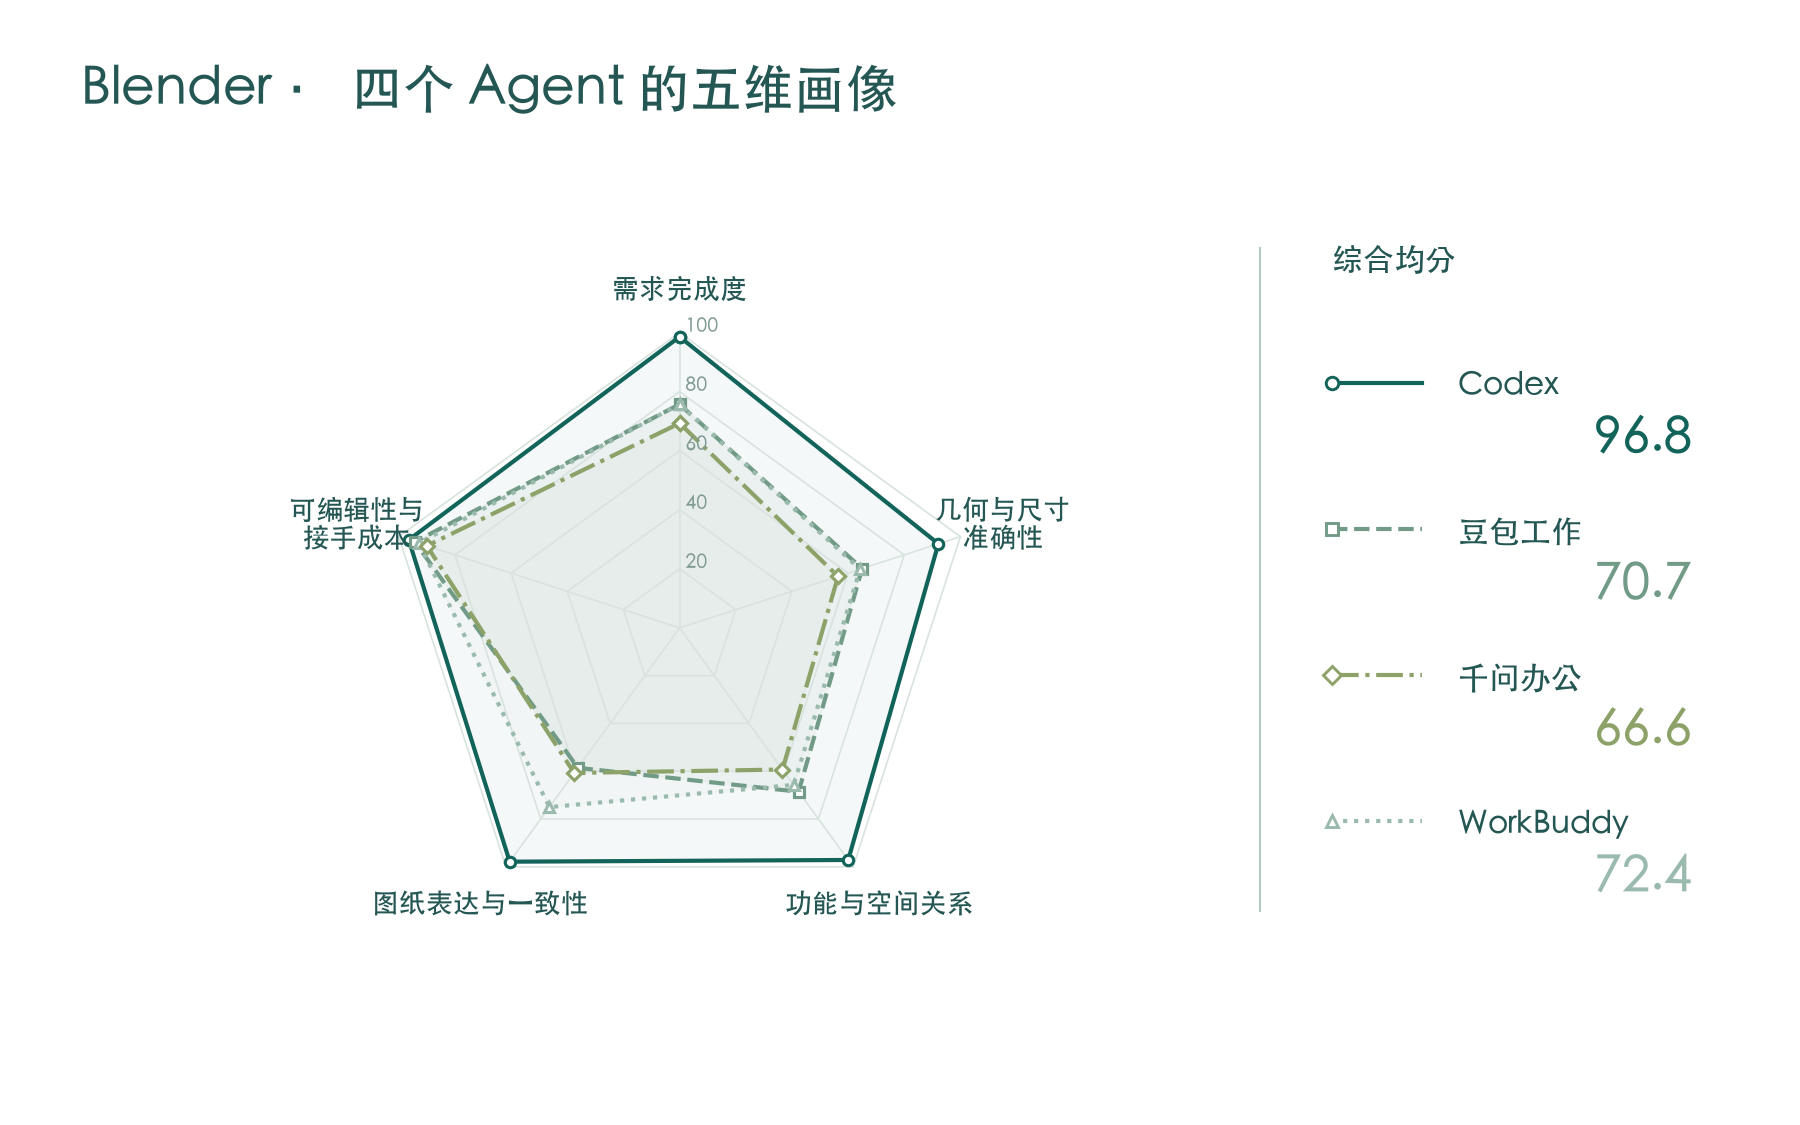
Blender:四个 Agent 的五维画像与综合均分

**需求完成度:交齐产物之后,差距在于落实了多少具体要求。**Codex 在所有题目中需求完成度得分最高,实际产物也保留了更多可与参考逐项对应的结构。以瓦力机器人为例(下文会详细说明),四家都交出了整机、爆炸模型和 PDF,但 WorkBuddy、千问办公在瓦力眼部、机械臂和履带仍有较多简化。

**几何与尺寸准确性:细节丰富,不等于形态还原准确。**这是三维参考还原中突出的提升空间。还是以瓦力机器人为例,豆包做出了瓦力的分层镜头与颈部支架,整体比例仍偏离参考;Codex 的镜头细节更丰富,却也没有准确保留双眼的倾斜姿态。
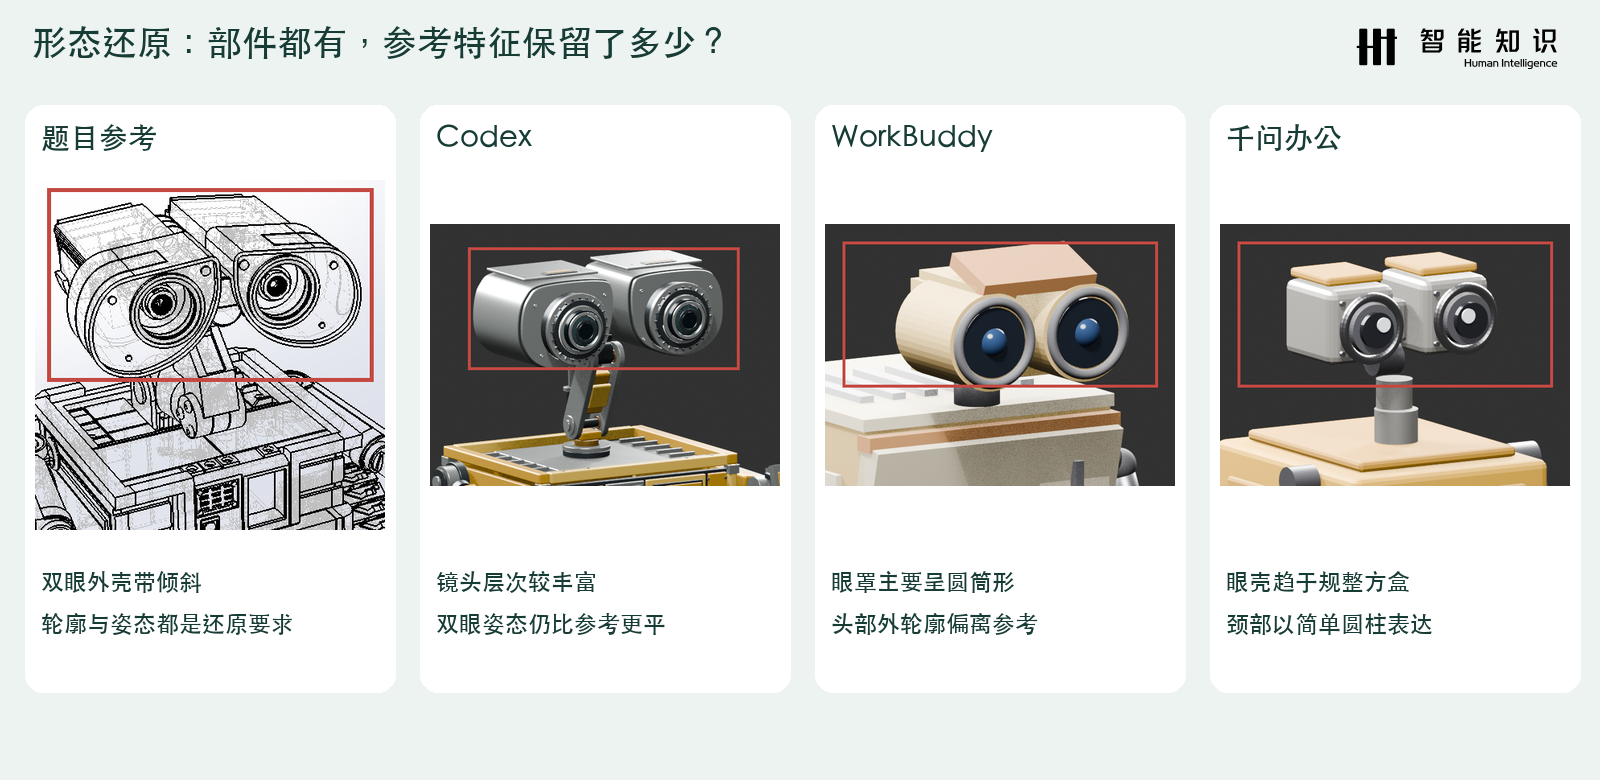
形态还原:瓦力参考与 Codex、WorkBuddy、千问办公的交付细节对比
瓦力参考与交付细节:框选眼部形态。

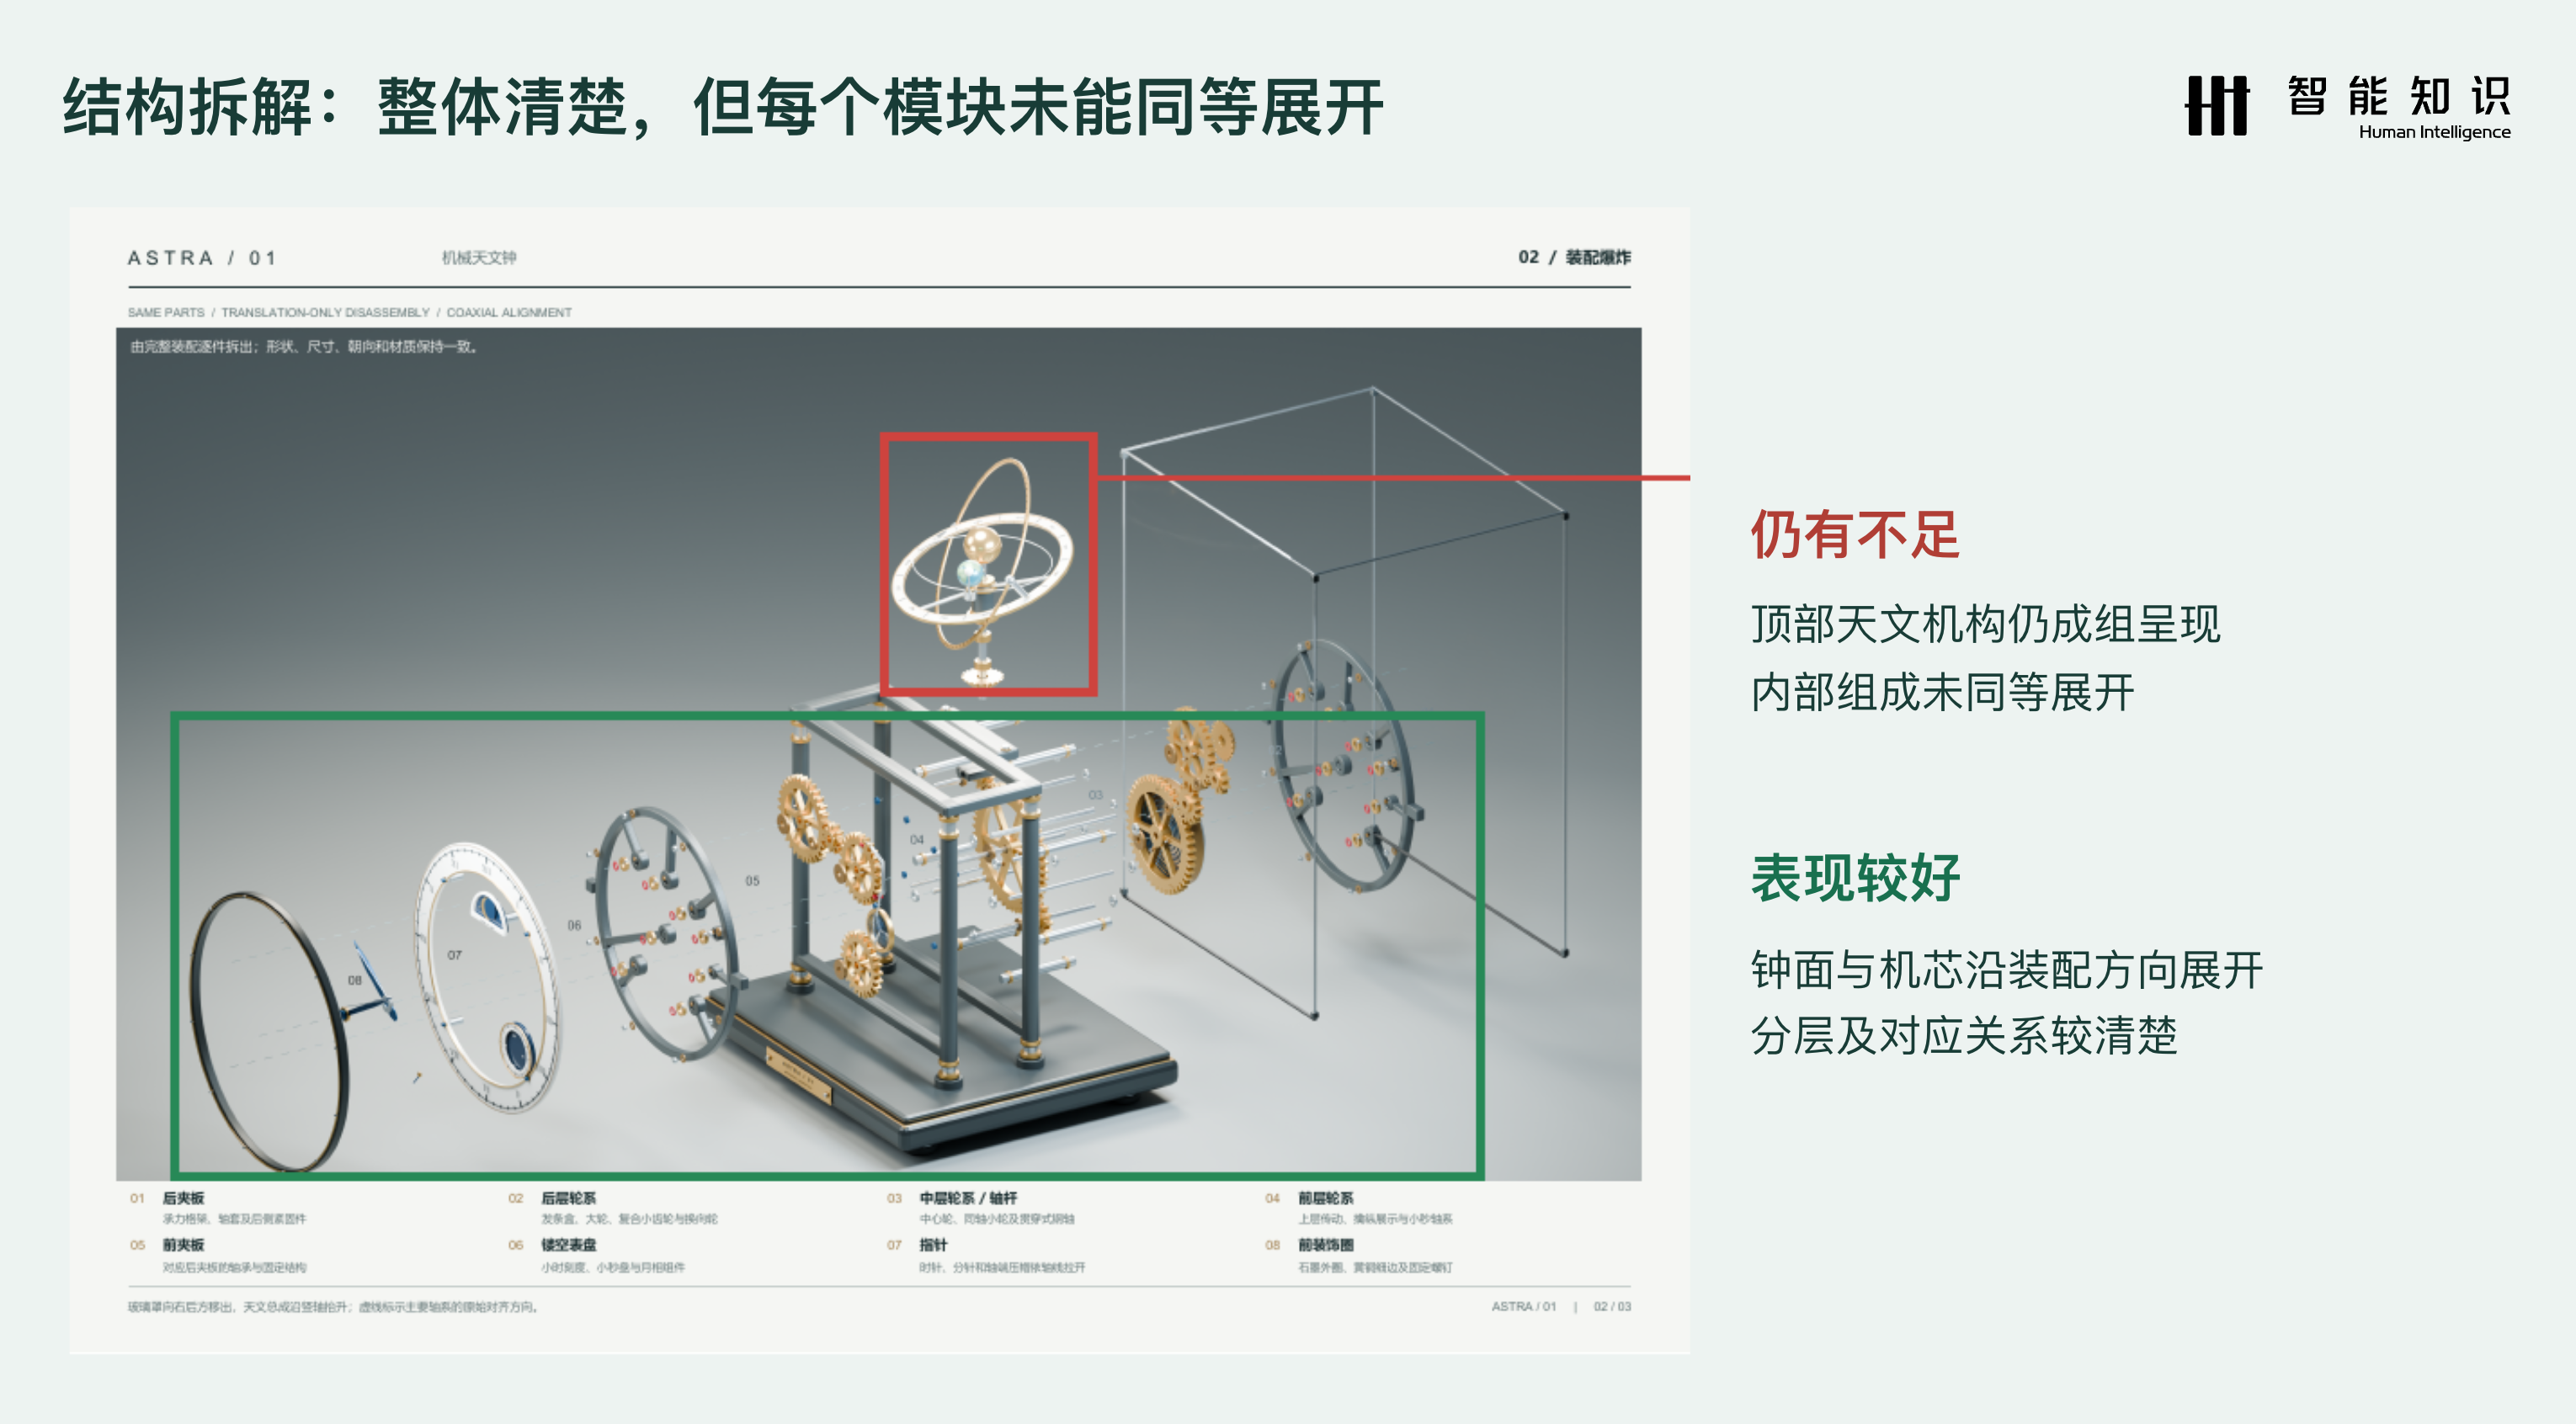
**功能与空间关系:能把零件拆开,还要把装配关系讲清楚。**Codex 的瓦力拆解层次较清楚,WorkBuddy 的部分部件则集中在箱体周围、相互遮挡;到天文钟,Codex 虽然展开了钟面与机芯,顶部天文机构仍成组保留。高分产物也存在拆解覆盖不足;这些静态证据能判断结构表达,不能直接证明机构实际可运转。
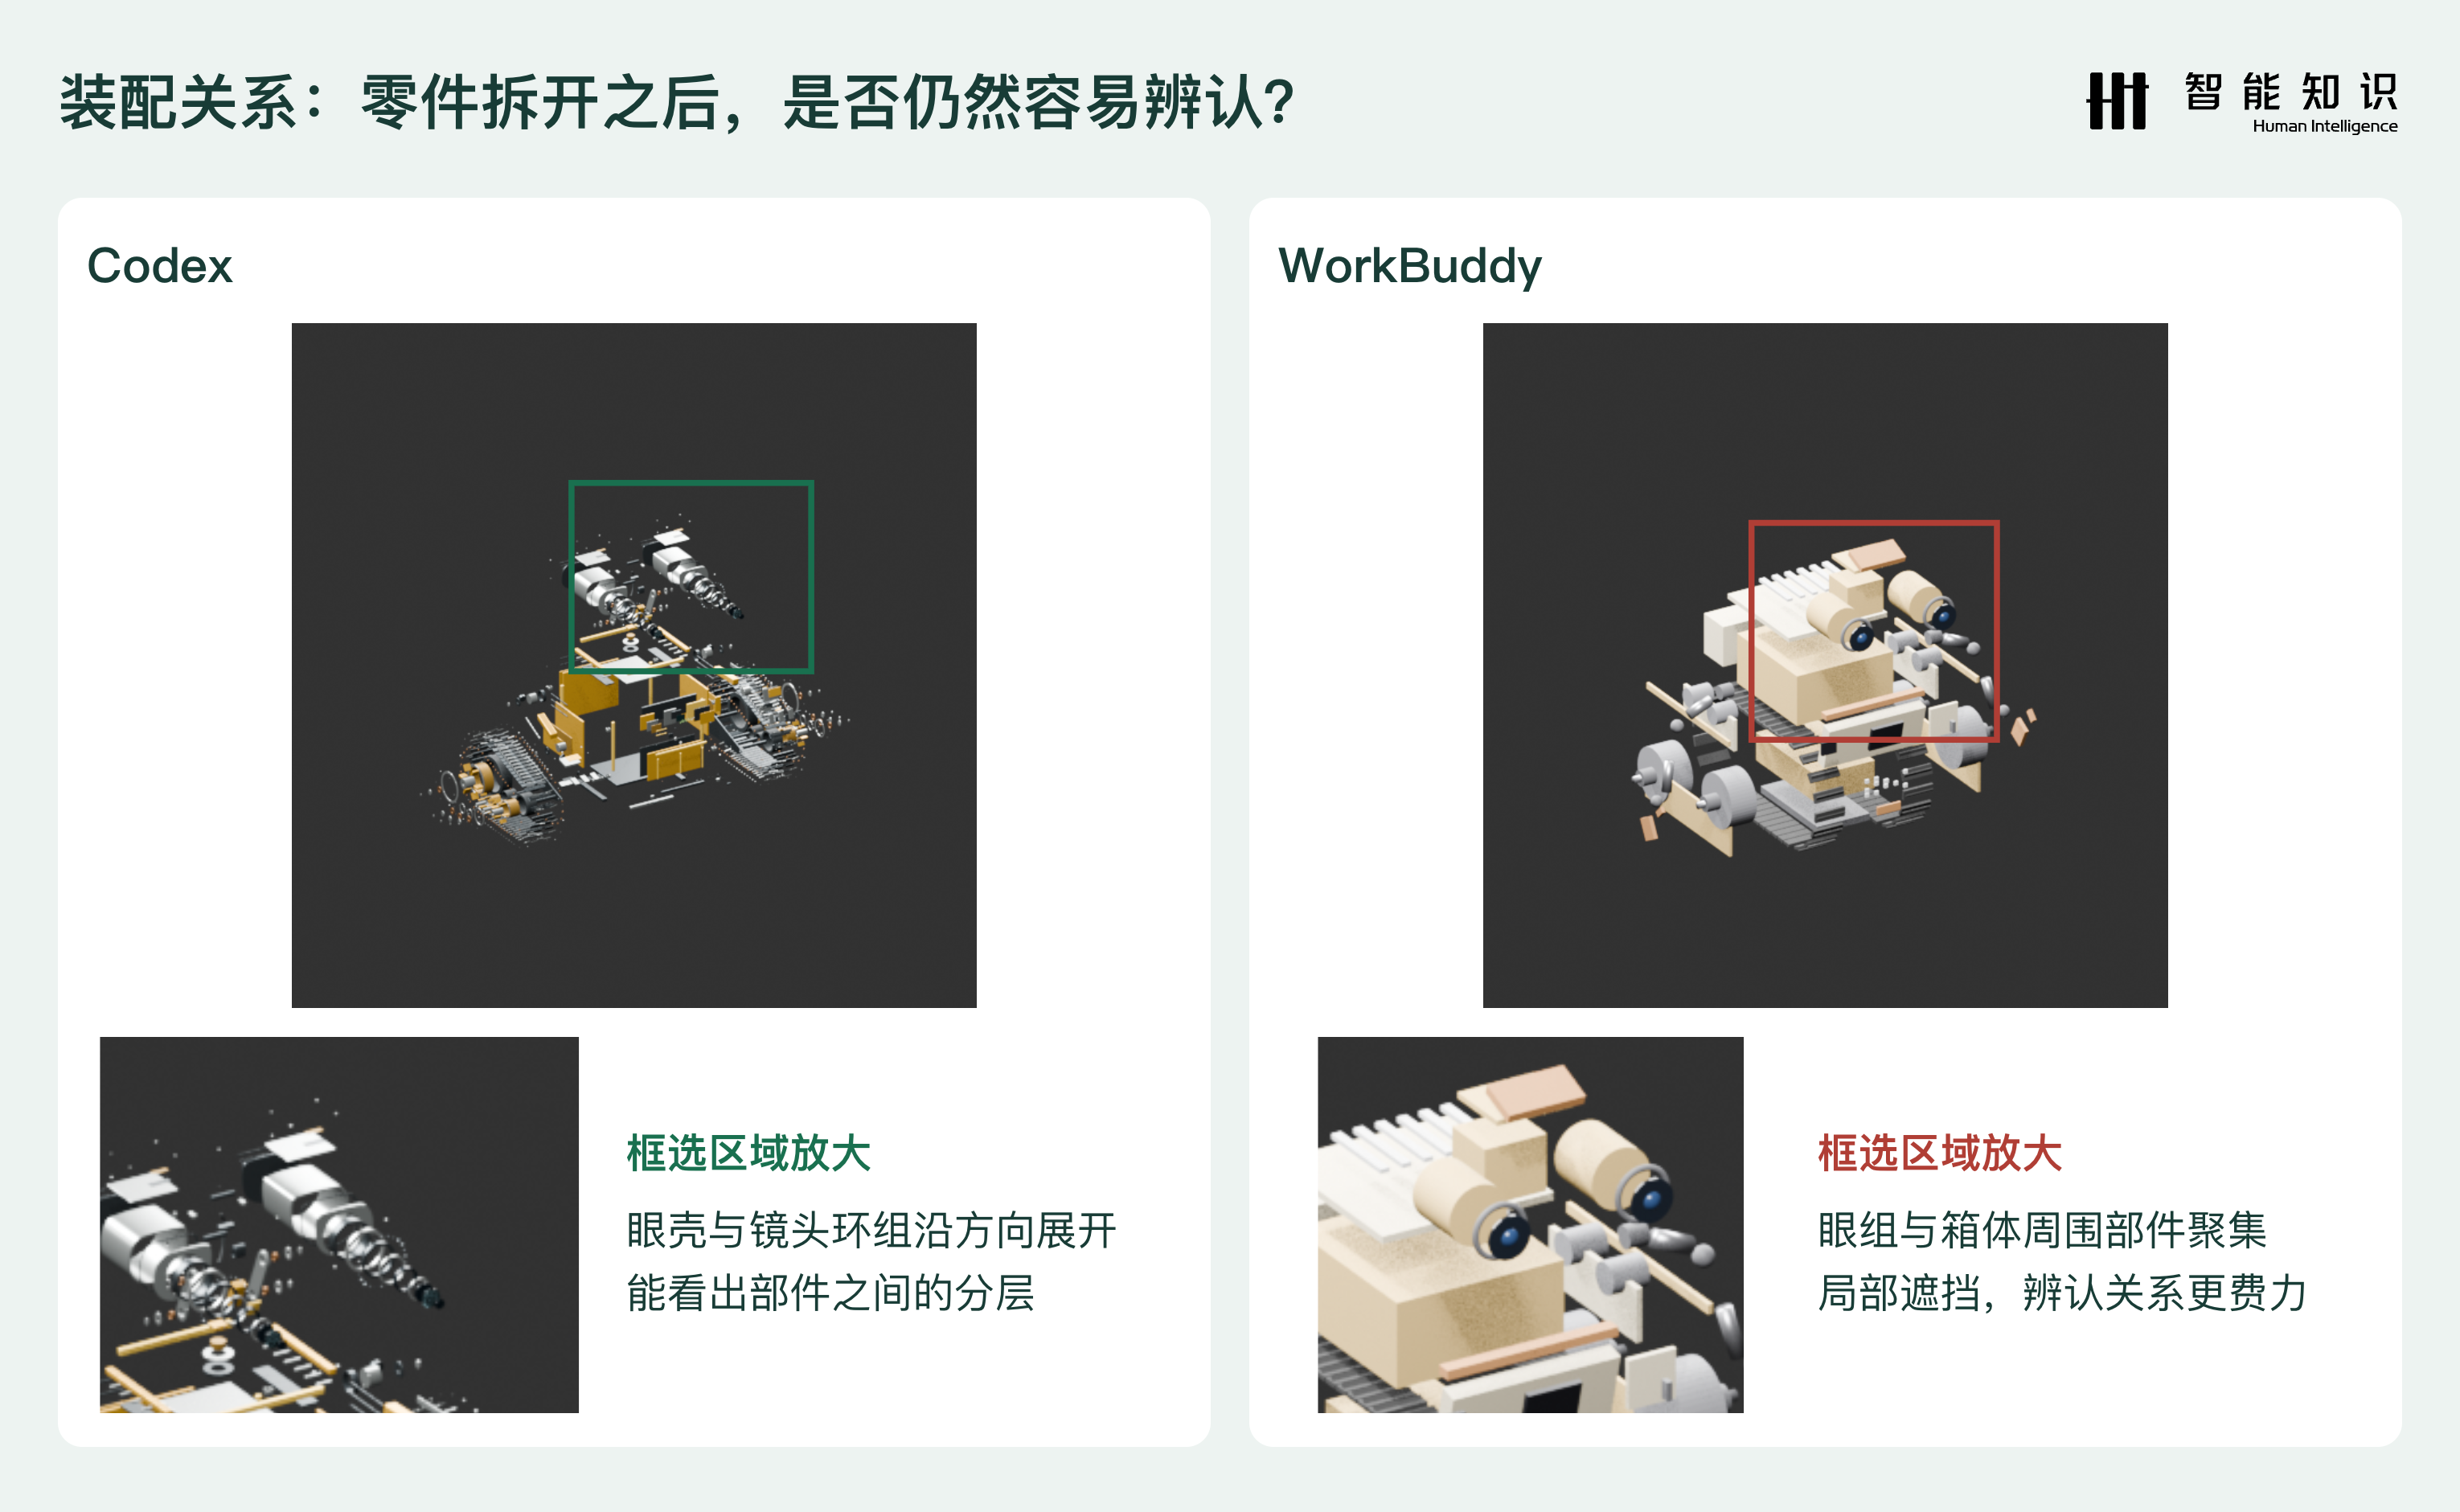
装配关系:零件拆开之后,Codex 与 WorkBuddy 的瓦力爆炸图对比
结构拆解:天文钟整体清楚,但每个模块未同等展开

**图纸表达与一致性:模型里有的内容,也可能在交付图册里看不清。**WorkBuddy 的缝纫机图册视图与传动说明较完整,但个别题目中仍出现图文遮挡;豆包也有图幅偏小、文字压图的问题。
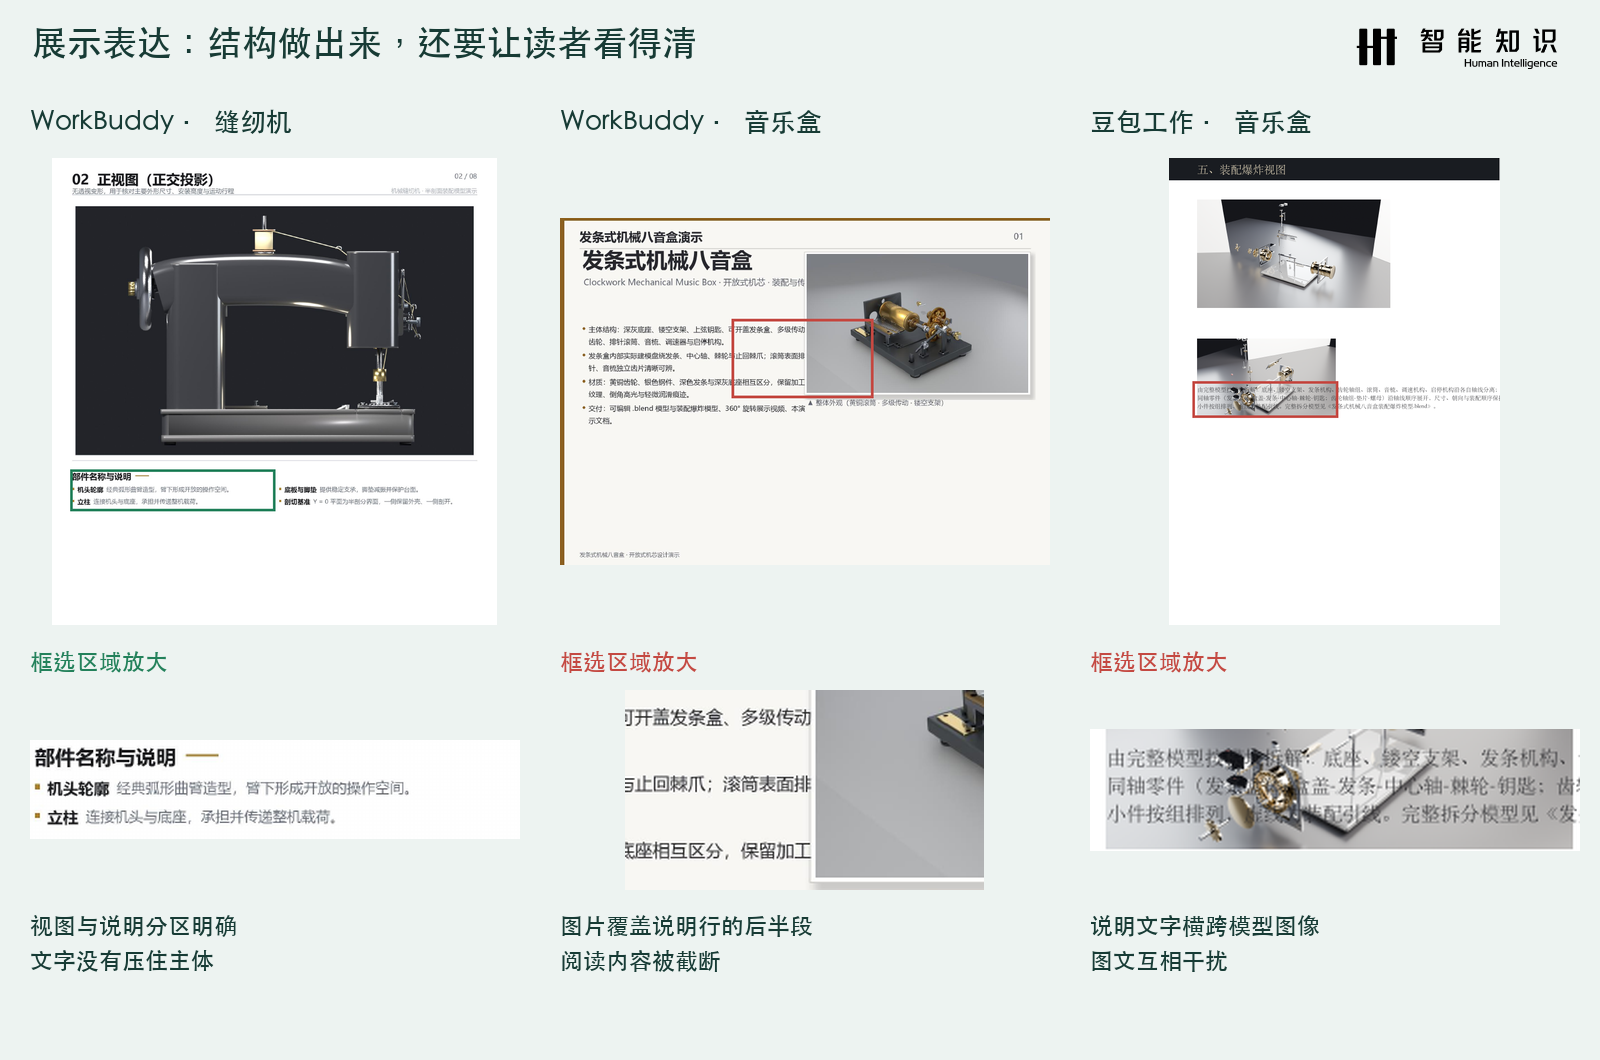
展示表达:WorkBuddy 缝纫机、WorkBuddy 音乐盒、豆包工作音乐盒的交付图册对比
原交付图册的整页与局部放大:清晰分区、图片覆盖文字和文字压图。

**可编辑性与接手成本:四家都留下了可继续修改的基础,后续修正量却不同。**四家在这一维度的均分都达到 90 分及以上,交付的 Blender 工程文件均能正常打开并继续编辑。不过,从“能修改”到“改到符合要求”,仍有工作要做:有的需要调整部件角度,有的需要重做简化机构,还有的需要整理图册。本轮未测量这些修改所需的时间,因此高分说明文件具备继续编辑的基础,不能直接说明后续修改省力。
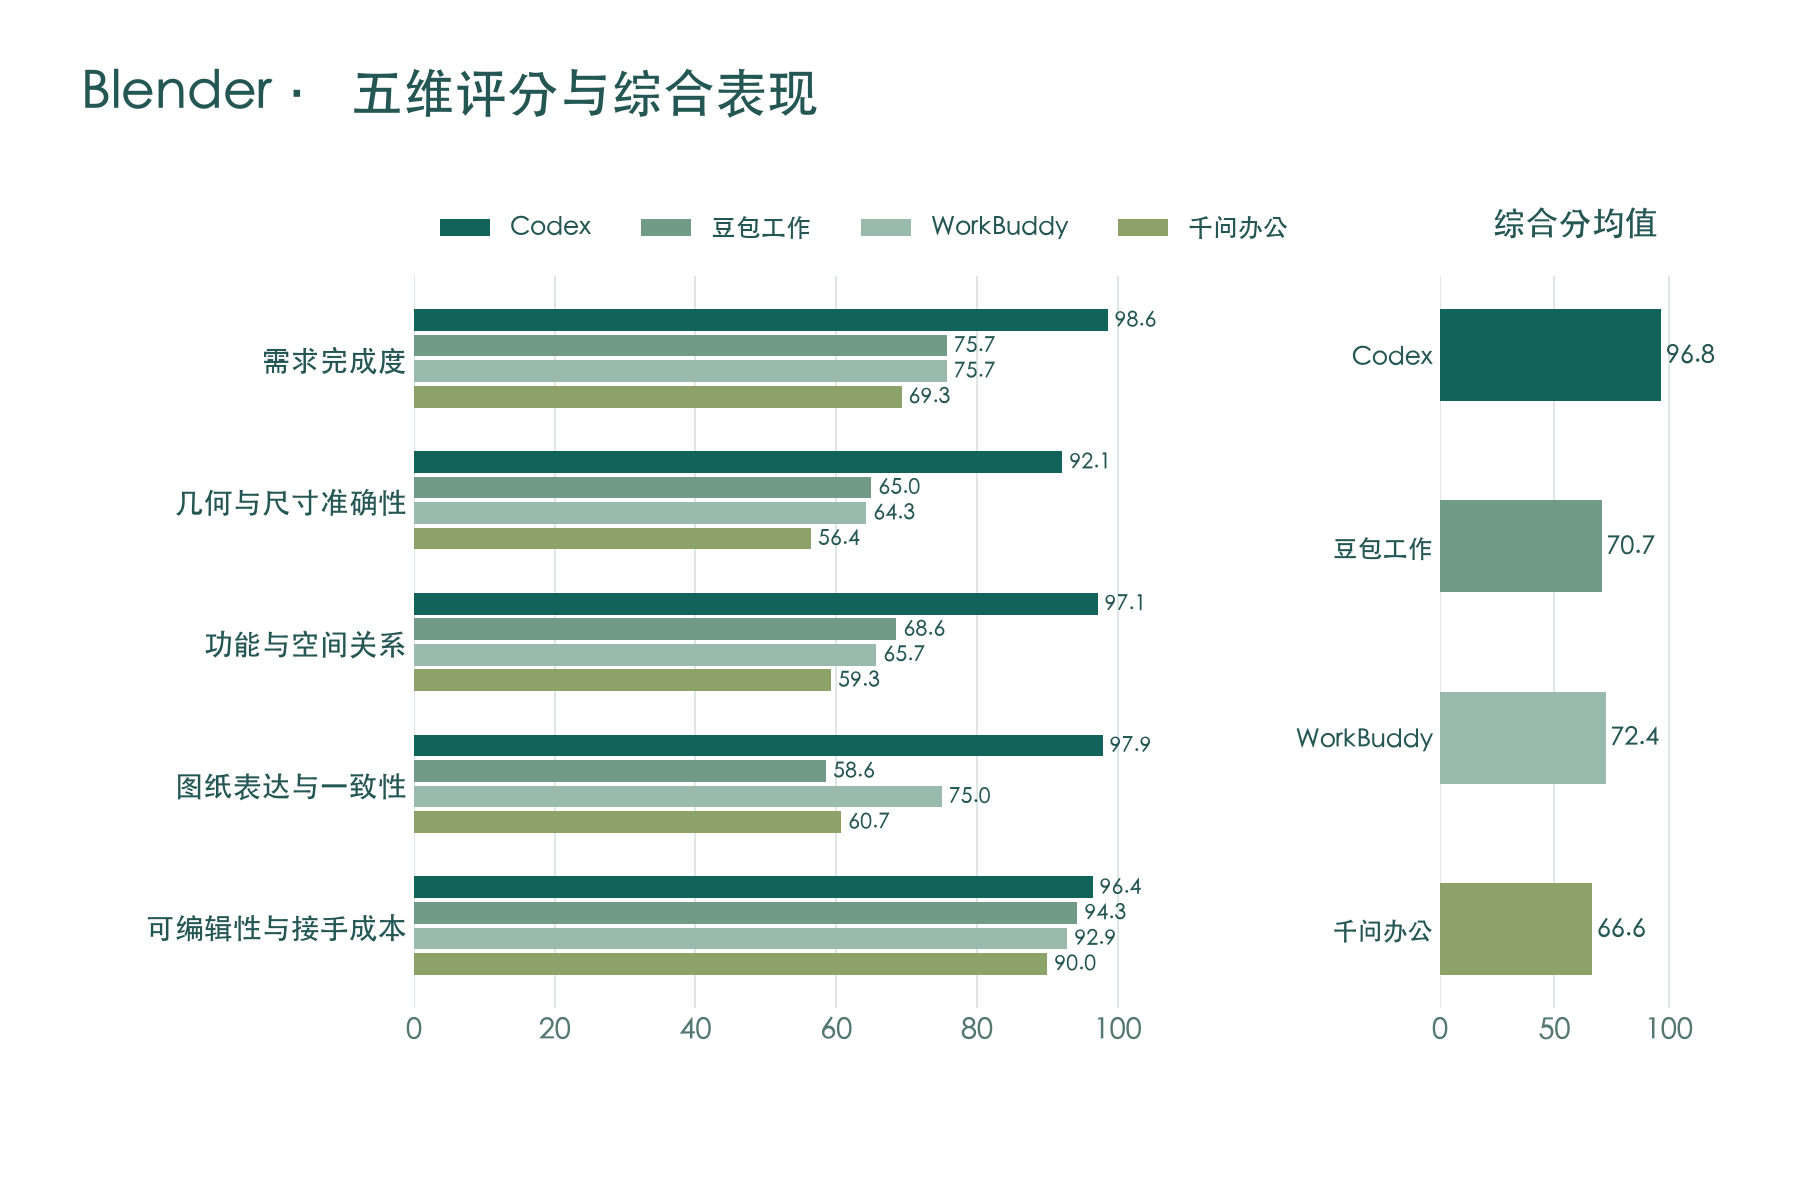
四个 Agent 的五维得分与综合分

Codex 领先,国内 Agent 的追赶空间在哪里?

这轮 Blender 评测中,Codex 展现了更强的综合能力:既保留了更多模型细节,也更完整地落实了任务要求。但国内几款 Agent 同样交出了模型、动画和可继续编辑的工程文件,在部分任务中也能清楚表达结构、完成有效修正。对于愿意从初稿开始迭代的使用者,它们已经值得拿自己的实际任务试一试,看看哪些工作能交给 Agent,哪些环节还需要自己把关。

这些案例也让进步方向变得更加具体:更准确地理解参考中的形状和动作,更合理地安排建模与渲染步骤,以及在交付前检查轮轴、部件关系和关键画面,都可能改善最终结果。这里既有模型理解与推理能力的空间,也有 Agent 工具使用、流程设计和验收机制的空间。WorkBuddy 的反复返工、豆包对局部问题的有效修正,都说明:如何检查、检查什么、发现问题后怎样改,会直接影响交付质量。

Codex 的领先值得重视,国内 Agent 和模型已经做到的部分也值得继续探索。我们期待后续评测中看到,更多产品能把这些具体短板逐一补齐,让用户拿到的作品更准确,也更容易接着用。

关注我们,后续将带来更多 AI Agent 横向评测,一起看看它们在真实任务中的表现。

Blender 评测中的四款 Work Agent:Codex、WorkBuddy、豆包工作、千问办公

上一期,我们比较了 Codex、WorkBuddy、豆包工作和千问办公在 AutoCAD 中的实际交付。这一期,我们继续聚焦工业场景,把考场搬到 Blender,看看这四款 Work Agent 在三维建模与动画任务中的表现。

我们都测试了什么

我们邀请了 8 位行业专家,共准备了 37 道题目。我们既看模型与动画是否符合要求,也检查交付的工程文件能否让人接着修改和使用。

我们都测试了什么:Roadster 飞跃复刻、瓦力机器人、机械天文钟、发条音乐盒等题目

本篇主要介绍其他 36 道题,其中《Roadster 飞跃复刻》的详细过程,欢迎查看《最强 Agent,能否复原出特斯拉飞行汽车?》,了解 4 家 AI Agent 详细复刻过程和最终效果。

成绩与能力差异:谁领先,优势在哪里?

综合本轮评估结果,**Codex 以 96.8 分领先,WorkBuddy 为 72.4 分,豆包工作为 70.7 分,千问办公为 66.6 分。**Codex 在五个维度上的均分均为最高;其余三家各有短板,其中 WorkBuddy 的展示表达较好,豆包工作的功能与空间关系得分略高。四家的可编辑性都达到 90 分及以上,真正拉开差距的,更多是几何细节、结构关系,以及模型和展示能否一致地落实要求。

五个维度分别表现怎样?

Blender:四个 Agent 的五维画像与综合均分

**需求完成度:交齐产物之后,差距在于落实了多少具体要求。**Codex 在所有题目中需求完成度得分最高,实际产物也保留了更多可与参考逐项对应的结构。以瓦力机器人为例(下文会详细说明),四家都交出了整机、爆炸模型和 PDF,但 WorkBuddy、千问办公在瓦力眼部、机械臂和履带仍有较多简化。

**几何与尺寸准确性:细节丰富,不等于形态还原准确。**这是三维参考还原中突出的提升空间。还是以瓦力机器人为例,豆包做出了瓦力的分层镜头与颈部支架,整体比例仍偏离参考;Codex 的镜头细节更丰富,却也没有准确保留双眼的倾斜姿态。

形态还原:瓦力参考与 Codex、WorkBuddy、千问办公的交付细节对比
瓦力参考与交付细节:框选眼部形态。

**功能与空间关系:能把零件拆开,还要把装配关系讲清楚。**Codex 的瓦力拆解层次较清楚,WorkBuddy 的部分部件则集中在箱体周围、相互遮挡;到天文钟,Codex 虽然展开了钟面与机芯,顶部天文机构仍成组保留。高分产物也存在拆解覆盖不足;这些静态证据能判断结构表达,不能直接证明机构实际可运转。

装配关系:零件拆开之后,Codex 与 WorkBuddy 的瓦力爆炸图对比
结构拆解:天文钟整体清楚,但每个模块未同等展开

**图纸表达与一致性:模型里有的内容,也可能在交付图册里看不清。**WorkBuddy 的缝纫机图册视图与传动说明较完整,但个别题目中仍出现图文遮挡;豆包也有图幅偏小、文字压图的问题。

展示表达:WorkBuddy 缝纫机、WorkBuddy 音乐盒、豆包工作音乐盒的交付图册对比
原交付图册的整页与局部放大:清晰分区、图片覆盖文字和文字压图。

**可编辑性与接手成本:四家都留下了可继续修改的基础,后续修正量却不同。**四家在这一维度的均分都达到 90 分及以上,交付的 Blender 工程文件均能正常打开并继续编辑。不过,从“能修改”到“改到符合要求”,仍有工作要做:有的需要调整部件角度,有的需要重做简化机构,还有的需要整理图册。本轮未测量这些修改所需的时间,因此高分说明文件具备继续编辑的基础,不能直接说明后续修改省力。

四个 Agent 的五维得分与综合分

Codex 领先,国内 Agent 的追赶空间在哪里?

这轮 Blender 评测中,Codex 展现了更强的综合能力:既保留了更多模型细节,也更完整地落实了任务要求。但国内几款 Agent 同样交出了模型、动画和可继续编辑的工程文件,在部分任务中也能清楚表达结构、完成有效修正。对于愿意从初稿开始迭代的使用者,它们已经值得拿自己的实际任务试一试,看看哪些工作能交给 Agent,哪些环节还需要自己把关。

这些案例也让进步方向变得更加具体:更准确地理解参考中的形状和动作,更合理地安排建模与渲染步骤,以及在交付前检查轮轴、部件关系和关键画面,都可能改善最终结果。这里既有模型理解与推理能力的空间,也有 Agent 工具使用、流程设计和验收机制的空间。WorkBuddy 的反复返工、豆包对局部问题的有效修正,都说明:如何检查、检查什么、发现问题后怎样改,会直接影响交付质量。

Codex 的领先值得重视,国内 Agent 和模型已经做到的部分也值得继续探索。我们期待后续评测中看到,更多产品能把这些具体短板逐一补齐,让用户拿到的作品更准确,也更容易接着用。

关注我们,后续将带来更多 AI Agent 横向评测,一起看看它们在真实任务中的表现。

返回

更多博客