返回文章列表

真实工作场景中的AI:Kimi 3.1 pro 在证券领域究竟进步了多少

武传惠发布于2026年11月6日
返回文章列表

真实工作场景中的AI:Kimi 3.1 pro 在证券领域究竟进步了多少

武传惠发布于2026年11月6日

证券行业的真实工作现状

截至 2025 年末,全国 150 家证券公司总资产 14.83 万亿元,全年营业收入 5,411.71 亿元、净利润 2,194.39 亿元[1];行业登记从业人员 36.87 万人,其中保荐代表人 8,526 人、证券分析师 6,109 人[2]。这个行业的日常工作,大多是在截止时点前把招股书、定期报告、合同条款、成交流水、研报和监管规则逐条核对清楚:投行写底稿、过内核,研究和投后拆财报、核验盈利预测,运营和财务做申赎确认、月结勾稽,风控盯偿债和退市风险。每个数字都要能追溯到来源,出错要追责:2025 年的高额罚单集中在投行业务,机构和直接责任人员同时受罚[3]。

AI 能给证券行业带来怎样的变化?

大模型已经进入券商一线流程。广发证券上线了流水核查、文档审核、债券底稿复核与自动生成等 56 项投行 AI 功能[4];深交所 2025 年的行业调研列出的场景还包括智能客服、投资决策支持、风险管理和智能投研[5]。这些场景处理的都是「读材料、对数字、写结论」,正是从业人员花时间最多的部分。

这种变化带来的真实价值有多大

OpenAI 的 GDPval 测评发现,前沿模型在 44 个职业的真实工作产出上已接近行业专家,有人监督时能做得更快、更便宜[6]。但证券行业对错误的容忍度很低:2026 年 6 月,方正证券一份周报把 2024 年的国常会表述标成 2026 年的最新部署,业内评价是「AI 仅是工具,最终责任必须由签字分析师与机构承担」[7]。所以 AI 在这里的价值,要看关键数字和口径算得对不对,而不是报告写得像不像。

现在的 AI 能否支撑真实工作场景的需要

这个问题还没有答案。公开榜单大多测问答和代码;GDPval 测的是美国职业和英文材料,不涉及中国的监管规则、中文资料包和信息截止时点。月之暗面 2026 年 10 月发布的 Kimi K3.1 Pro 宣称金融研究和长程 Agent 能力明显提升[8],这需要用真实工作来检验。

基于真实工作场景的测评报告

我们用 10 道按证券一线岗位真实委托设计的交付题,对比 Kimi K3.1 Pro 和上一代 Kimi K3。

测评介绍

  • 题目:每题给出角色、读者、截止时点和交付要求,附 5–12 份材料,模型需自己读材料、建模型,交付可打开的 Excel / Word 文件。题面要求 4 小时内完成(图 5 中的「题面预算」,对应真实工作的交付时限);沙箱运行超过 7 小时会被强制终止。

  • 运行:两个模型使用同一 Agent 框架(Claude Code)和同一沙箱,每题跑 1 次;非模型原因的失败最多重跑 2 次。

  • 评分:每题 28–40 条评分细则,覆盖结果正确性、专业质量、指令遵循、格式、语气,分关键项、重要项、加分项三档,另有一票否决项。裁判模型 gpt-5.6-sol 打开交付文件逐条判定,折算为 0–100 分。同一套题另有 opus-5、gpt-5.6-sol、seed 的参考分,裁判和公式相同。

  • 未交付:ETF 联接基金一题,Kimi K3 共运行 3 次:前 2 次执行超时、按规则重跑,第 3 次跑了 63 分钟、62 轮,仍没有写出任何交付文件,记 0 分;Kimi K3.1 Pro 得 55.8 分。为保持同题可比,下文均分按两边都有交付的 9 题计算;算上这一题,10 题均分为 31.5 → 47.0。

覆盖了哪些真实工作场景

工作场景 交付对象 交付物
定增认购评估与报价授权 投委会 测算表 + 决策备忘
经纪业务佣金收入月结复核 财务负责人 月结报告 + 四表台账
*ST 持仓标的退市风险复核 风险总监、投决会 测算表 + 复核报告
IPO 内核前质控复核 项目负责人、内核 复核明细 + 验收意见
永续策略账户网格配置复核 投委会 四表配置表
理财产品流动性压力测试 管理层 含看板和证据索引的工作簿
Pre-IPO 可研报告风险章节复核 风险管理部、投决会 修订稿 + 六表底稿
ETF 联接基金投资价值分析 投资决策者 分析报告
子公司参与基金出资请示 公司决策层 请示
矿业龙头半年报后投资逻辑复核 基金经理、风控 备忘录 + 计算底稿

这些题共同要求:遵守信息截止时点,核对多来源记录的冲突,缺的数据标「待补」不得编造,Excel 用公式、Word 数字可追溯且两份文件一致,并给出明确结论。

综合能力是否增强

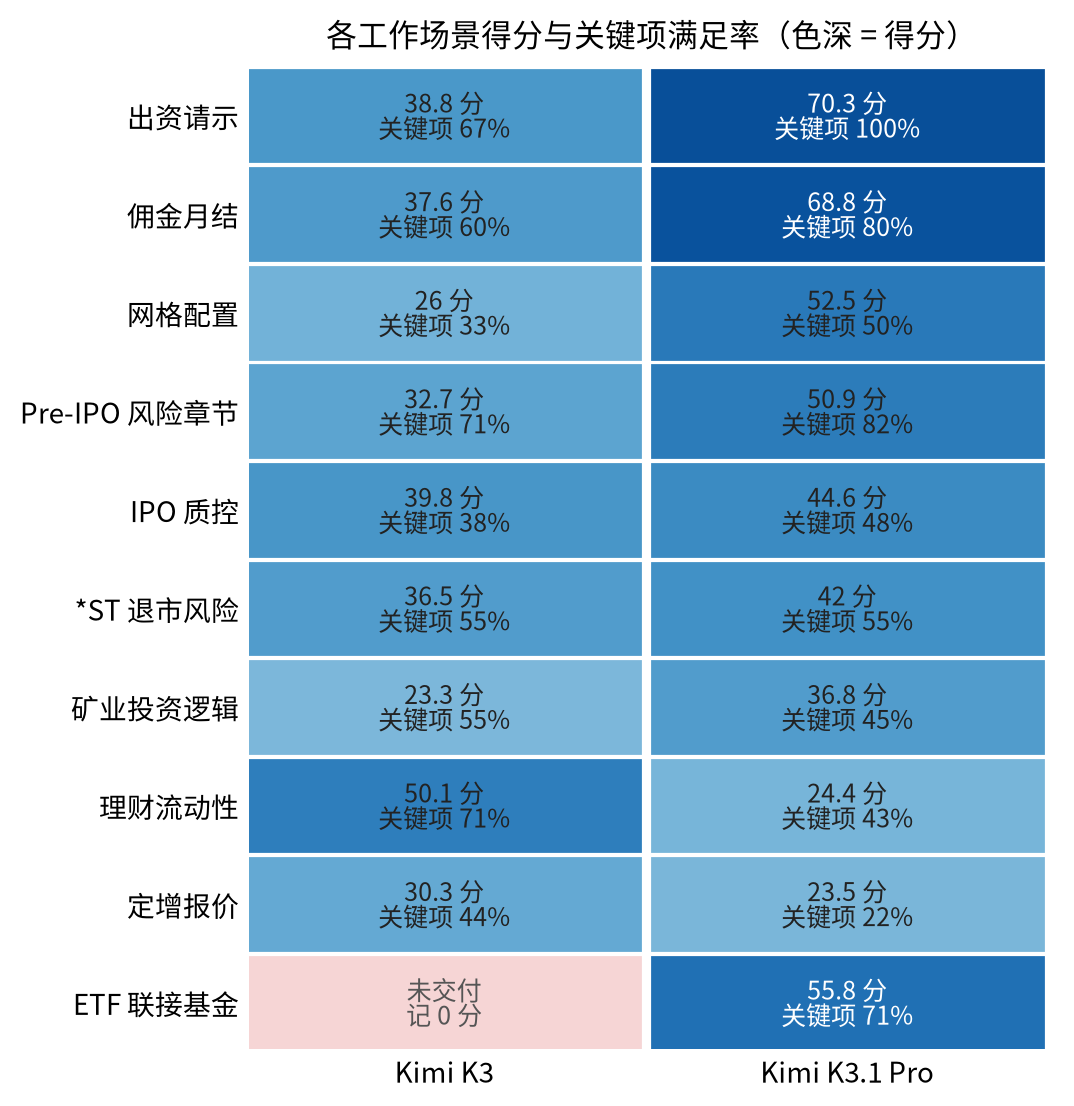
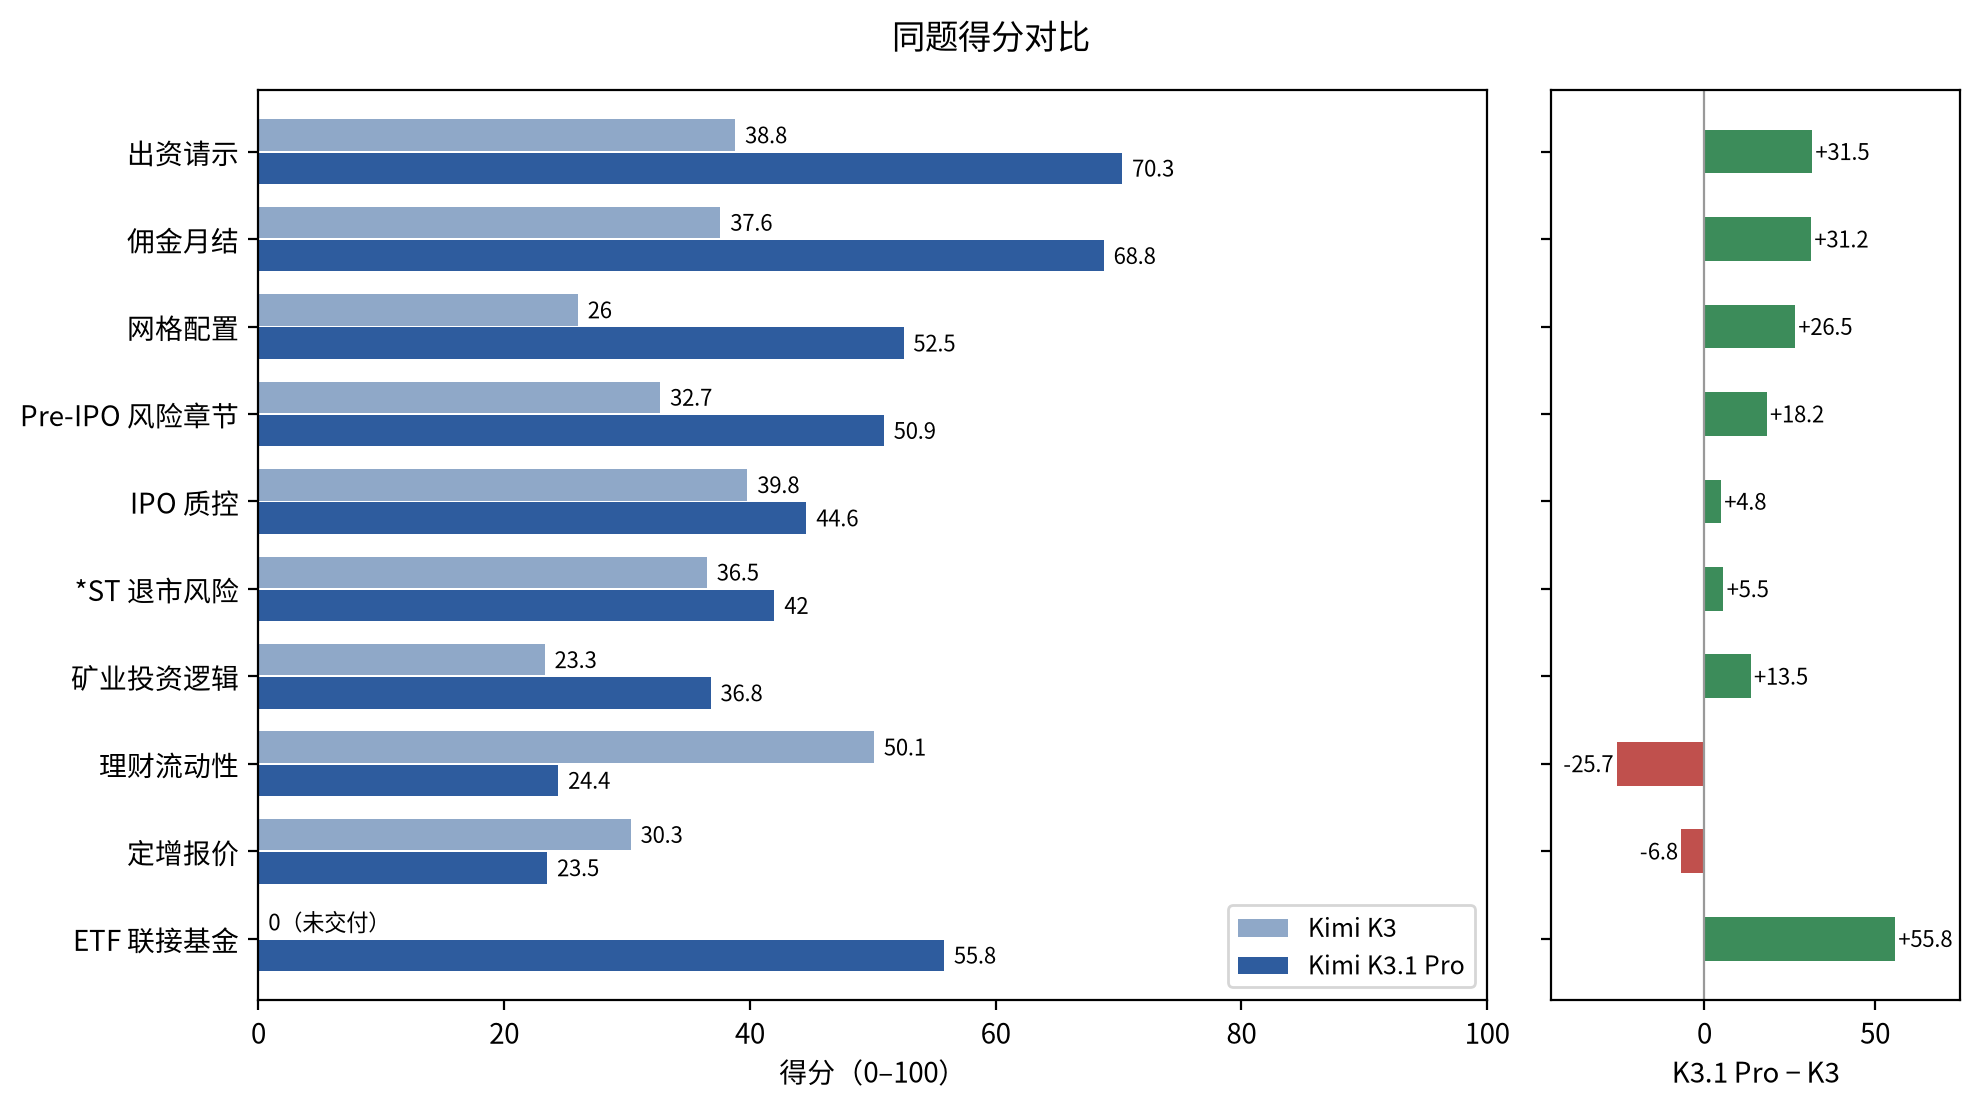
增强了,但不稳定。在两边都有交付的 9 题上,Kimi K3.1 Pro 的平均分从 35.0 提高到 46.0,7 题领先、2 题落后;关键项满足率只从 55% 提高到 58%,9 题里只有 5 题更高。
各工作场景得分与关键项满足率
图 1 各工作场景得分与关键项满足率
同题得分对比
图 2 同题得分对比(右侧为 K3.1 Pro − K3)

按维度看,格式从 71% 提到 93%,关键项只从 51% 提到 54%。K3.1 Pro 把该做的事做得更全了,但把关键数字算对这件事改善不多。
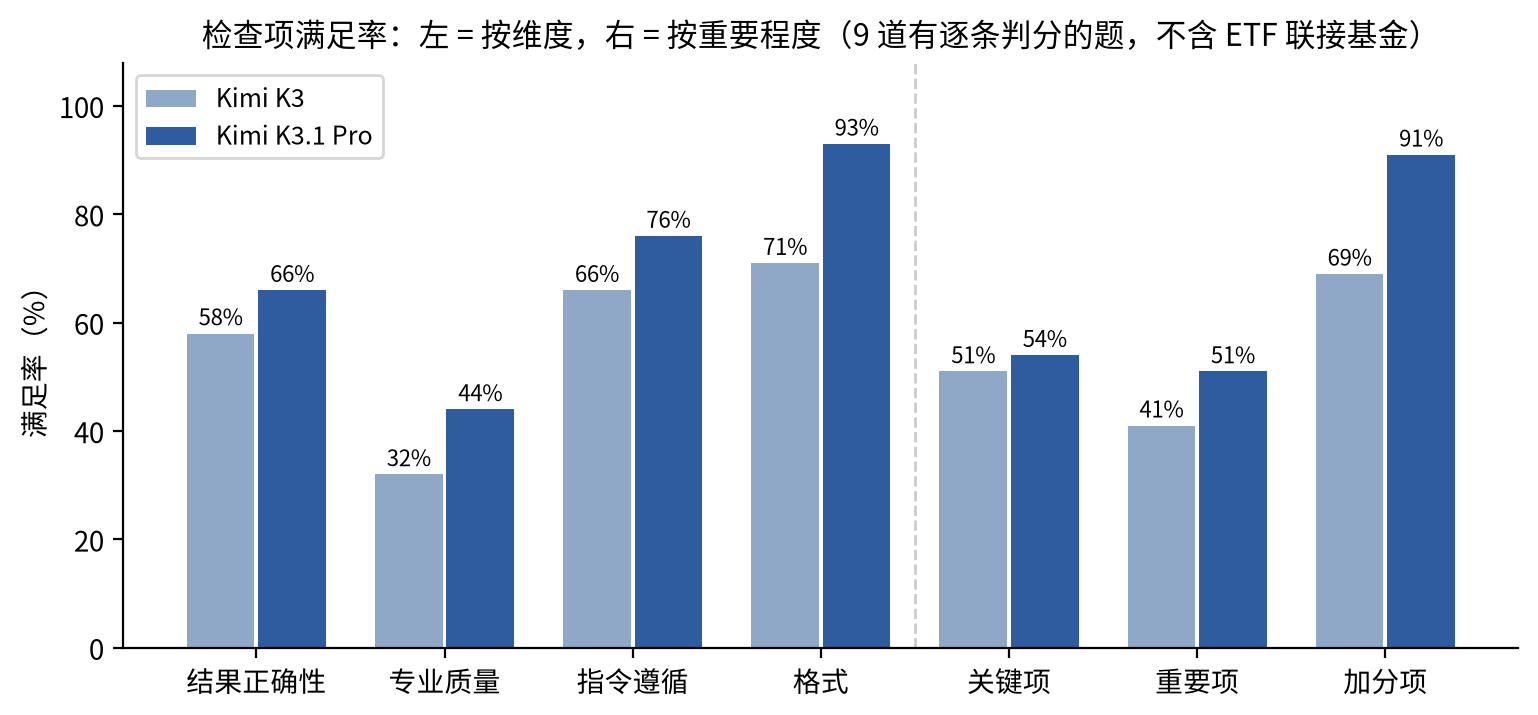
检查项满足率:按维度与按重要程度
图 3 检查项满足率:按维度与按重要程度

哪方面强,哪方面弱

强项是以依据为主的文书。 出资请示(70.3 分)和佣金月结(68.8 分)都提高了 30 分以上,也是五个模型在这套题上的最高两分。出资请示一题,K3.1 Pro 把公司披露和研报观点分层引用,把不确定的承诺衔接列为待核查,关键项全部满足。网格配置和 Pre-IPO 两题,它补上了逐行去重依据、缺数据标的的披露和盈利预测兑现率检验。

弱项是多条件筛选后再汇总的计算和规则细节。 理财流动性一题退步 25.7 分,原因是少筛了一个维度;定增一题的档位累计规则两代都没处理对。矿业龙头一题 K3.1 Pro 多得 13.5 分,关键项满足率却从 55% 降到 45%,多出的分来自格式和加分项。

失分归因:五类典型错误

1. 中间结果未传递至最终交付物。 矿业龙头一题,两个模型的底稿都算对了矿山产银毛利(2026H1 26.28 亿元、2025H1 8.27 亿元),但 K3 的备忘录没提,K3.1 Pro 只写了增量 18.01 亿元,都判不满足。这类问题每题有 4–15 条。

2. 取数筛选条件缺失,错误沿计算链向下游传导。 理财流动性一题,可用现金应只计托管活期和清算备付账户中「可用且已入账」的资金。K3 筛对了,得到 7,867.10 万元;K3.1 Pro 漏了账户类型,把受限保证金和待交收资金也算进去,得到 16,554.58 万元,缺口、覆盖率、回购额度三条关键项连带失败。

3. 多记录取数口径错误:重复累加或误用取值规则。 定增一题,邀请书规定申购金额取有效档位的最大累计额,K3 把 5,000 万元和 3,000 万元相加成 8,000 万元,K3.1 Pro 把 5,000 万元写成 3,000 万元。理财题同一资产的多条询价,两代都做了重复累加。

4. 数值精度与一致性判断错误。 IPO 质控一题,11,525.5 ÷ 29,142.7 = 39.5485%,应为 39.5%,两个模型都写成 39.6%,并据此认定「与披露值一致」。

5. 引用来源与所引数值不符。 K3.1 Pro「写了不该写的内容」从 8 次降到 6 次,但出现了更隐蔽的错误:Pre-IPO 一题它注明引自某附件第 03 表,写的控制比例是 31.9348%,源表是 32.5811496%。这类错误比没给出处更难被复核的人发现。

跟其他模型比起来怎么样
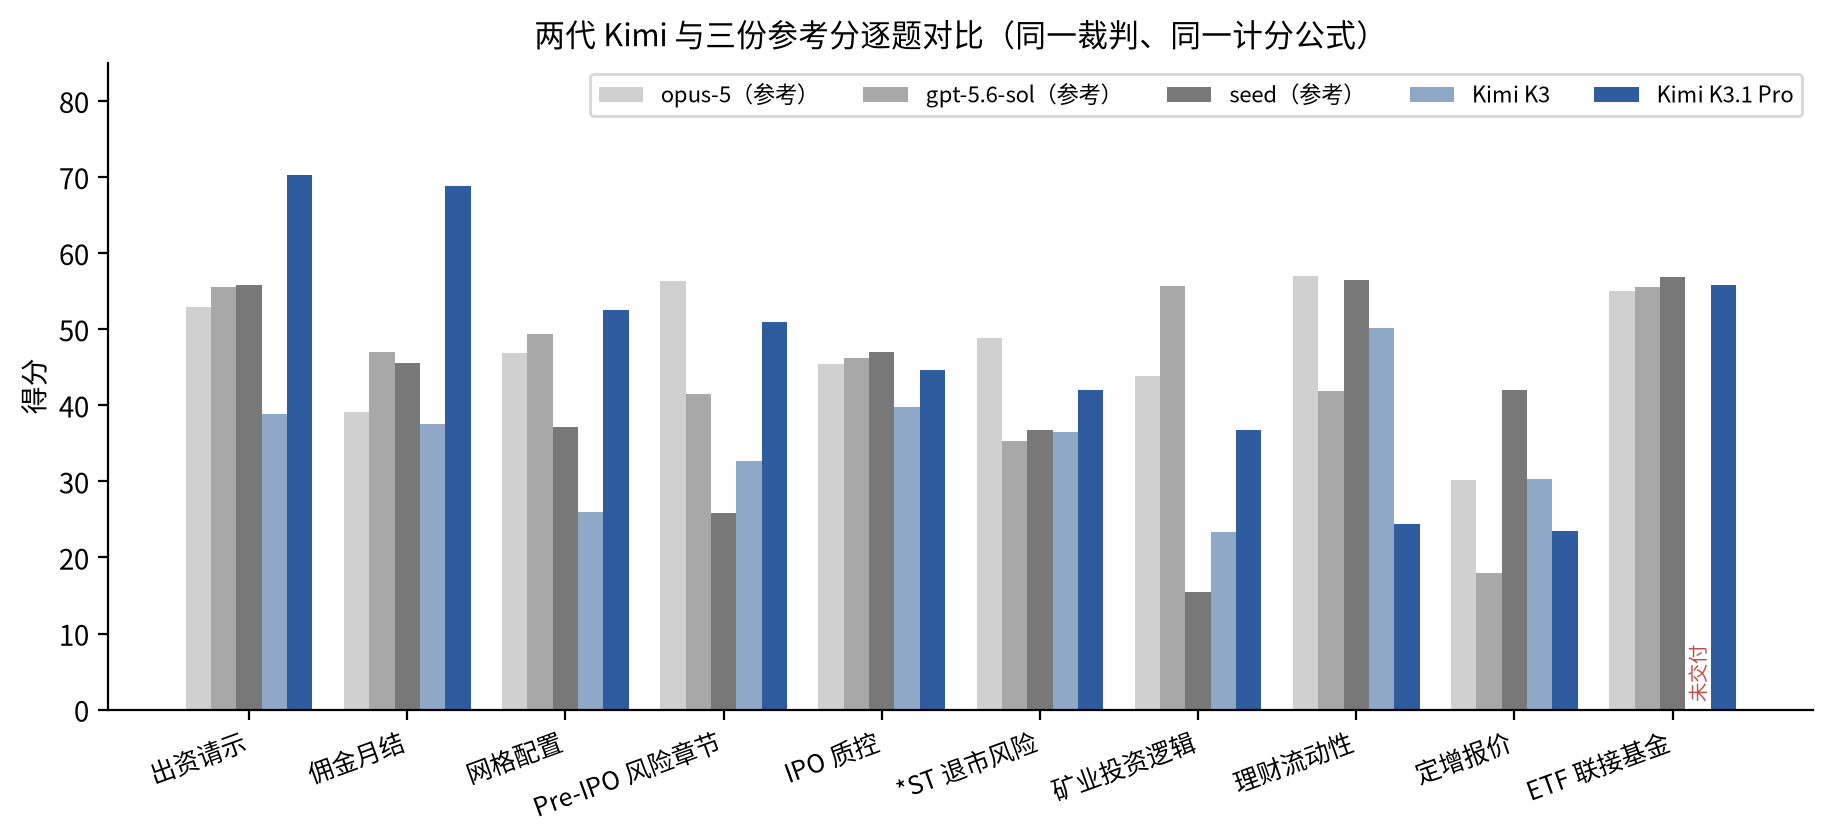
两代 Kimi 与三份参考分逐题对比
图 4 两代 Kimi 与三份参考分逐题对比

按两边都有交付的 9 题计,K3.1 Pro 均分 46.0,与 opus-5(46.7)基本持平,高于 gpt-5.6-sol(43.4)和 seed(40.2);K3(35.0)低于三份参考分。但五个模型均分都没超过 47 分,目前没有一个模型的交付物可以不经复核直接使用。参考分是单次运行结果,且裁判 gpt-5.6-sol 本身也在被对照之列,数字适合看方向。

耗时与成本如何

指标(10 题合计) Kimi K3 Kimi K3.1 Pro
平均每题耗时 32 分钟 68 分钟(约 2.1 倍)
输入 token 合计 17.9M 35.4M(约 2.0 倍)
缓存命中率 88% 83%
成本合计 $107 $156(约 1.5 倍)
每 1 分的成本(10 题) $0.34 $0.33
每 1 分的成本(两边都有交付的 9 题) $0.29 $0.33
每题耗时与输入 token
图 5 每题耗时与输入 token

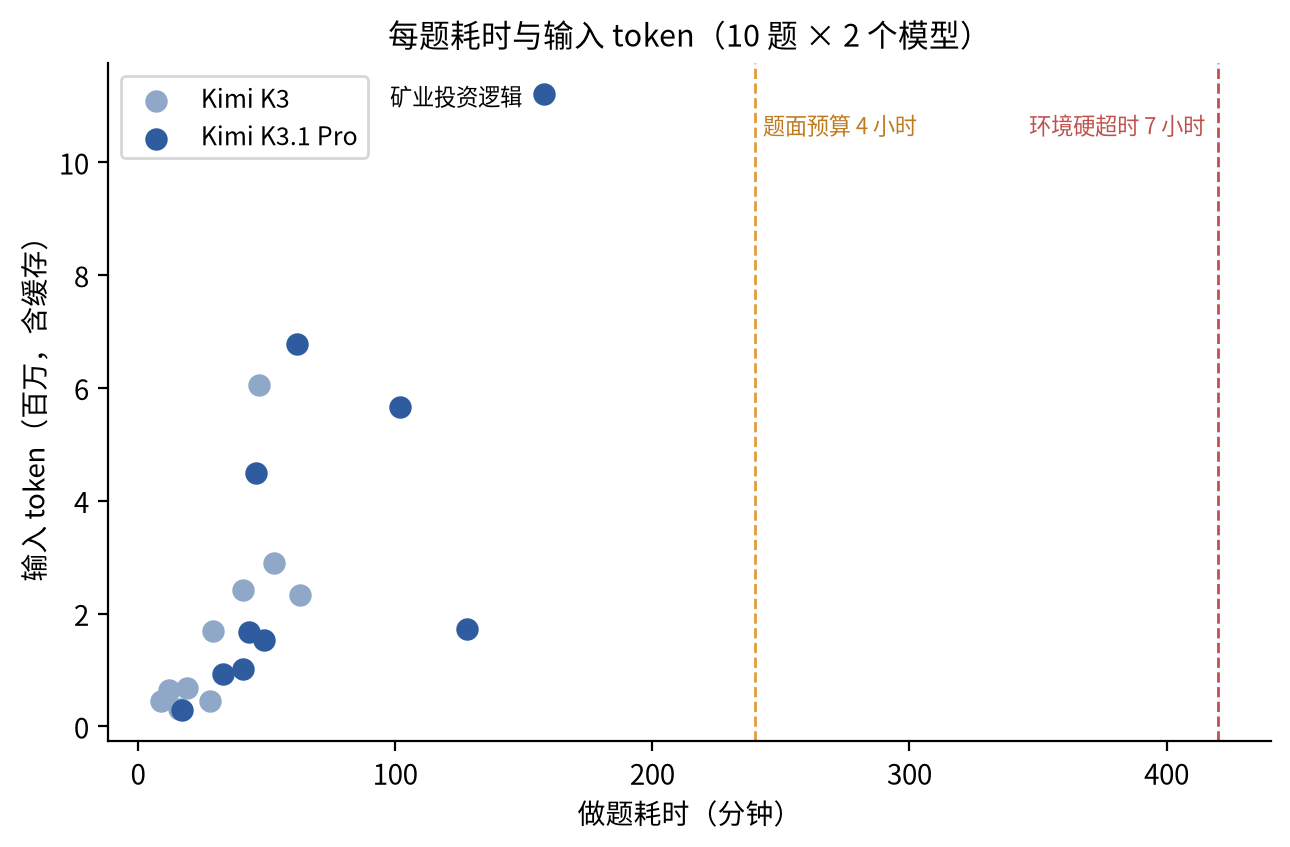
图 5 中橙色虚线是题面要求的 4 小时完成时限,红色虚线是沙箱 7 小时的强制终止线。20 次运行都在 4 小时以内结束。
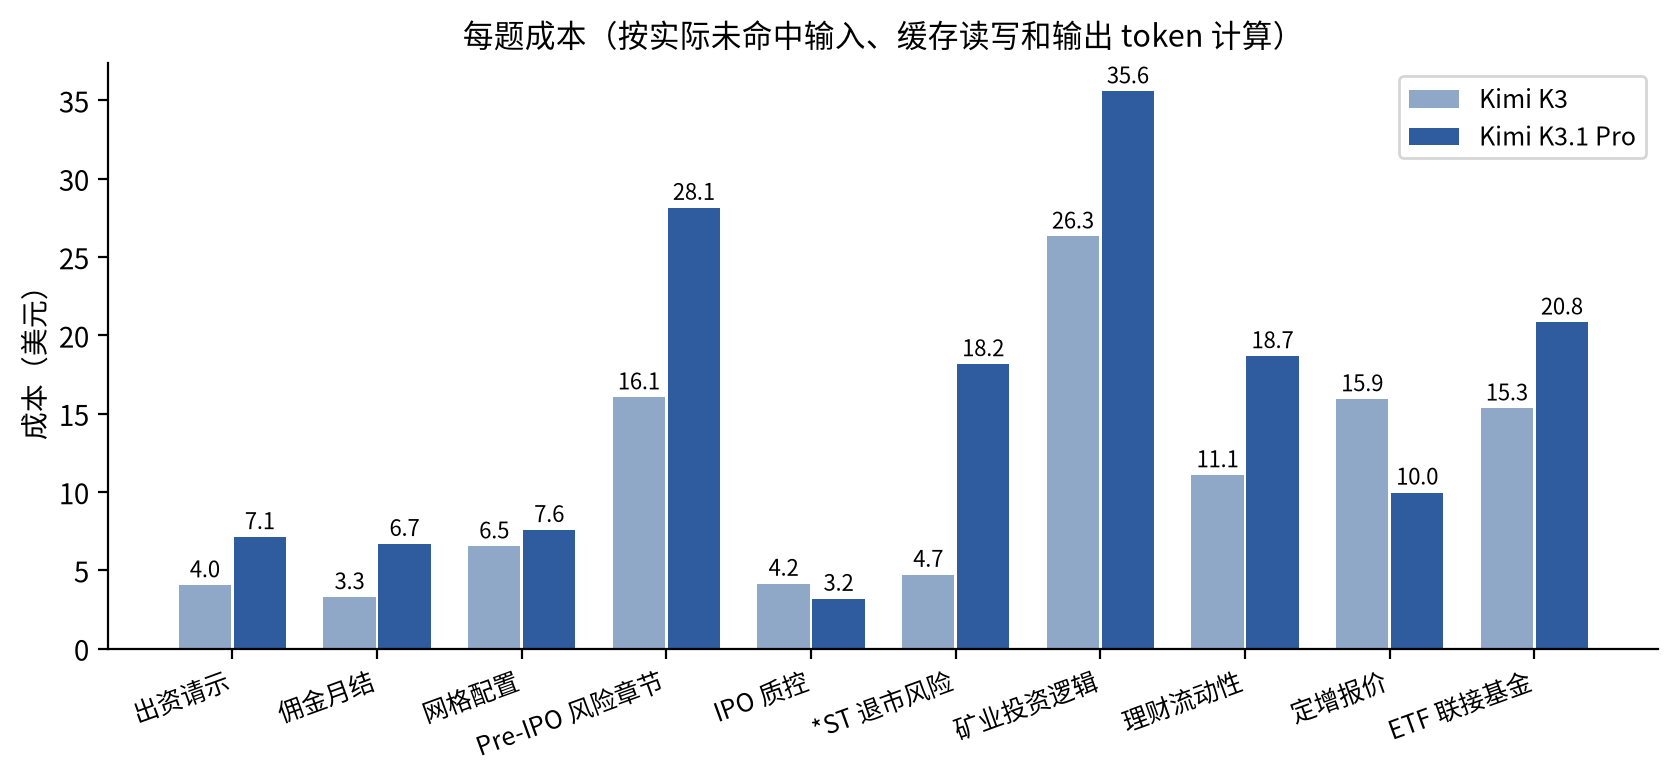
每题成本(按实际 token 计算)
图 6 每题成本(按实际 token 计算)

成本 = 每题实际 token 用量 × 单价,10 题合计(含 ETF 一题);token 用量取自评测执行记录,分未命中输入、缓存读取、缓存写入、输出四类。单价(美元 / 百万 token):K3 输入 20、缓存读取 2、输出 100;K3.1 Pro 输入 13、缓存读取 1.3、输出 68;缓存写入按输入单价计。

K3.1 Pro 单价比 K3 低三成多,但输入 token 约 2 倍、输出约 1.8 倍,缓存命中率也更低,总成本约 1.5 倍。命中率的差别集中在个别题:K3 各题在 77%–91% 之间,K3.1 Pro 在 46%–90% 之间,最低的是 *ST 退市风险一题,1.7M 输入里只有 0.8M 走缓存,花了 $18.17。按每 1 分算,10 题合计两者持平,但 K3 的数字里有 ETF 一题花掉、没换来交付的 $15.34;只看两边都有交付的 9 题,K3.1 Pro 每分贵约一成。所有题都在题面要求的 4 小时内完成,最长的是 K3.1 Pro 做矿业龙头一题,158 分钟、$35.58。

总结:Kimi 的进步,与它对真实工作的支撑能力

  • 进步是真实的:平均高 11 分,均分与 opus-5 持平,以依据为主的文书拿到全场最高分,「金融研究能力提升」在这套题上能看到。

  • 进步主要在完整度:格式和加分项大幅提高,关键项几乎没动。筛选口径、规则适用、舍入这些决定结论对错的环节,两代模型错在同样的地方;K3.1 Pro 还出现了「出处具体但数字不对」的新风险。

  • 更慢、更贵:耗时约 2.1 倍,成本约 1.5 倍;只看两边都有交付的 9 题,每 1 分的成本 K3.1 Pro 高约一成。

  • 离直接交付还有距离:五个模型均分都不到 47 分。现阶段适合让模型做初稿、搭底稿、梳材料,人工重点复核筛选条件是否完整、多条记录的取数规则、底稿数字是否写进报告、舍入判断,以及出处与数字是否对应。

局限:每题只跑 1 次,单次得分波动较大,结论应看方向;ETF 一题 K3 三次运行均未交付,同题比较按两边都有交付的 9 题计;评分来自大模型裁判;参考分的运行条件可能与本次不同。

前言数据来源

以下为第一部分「证券行业的真实工作现状」中行业规模、从业人数、罚单、券商 AI 应用、GDPval 测评和 Kimi K3.1 Pro 发布等事实的出处,对应正文方括号编号 [1]–[8]。测评数据来自本次实际运行记录,不在此列。

  1. 中国证券业协会:证券公司 2025 年度经营数据,https://www.sac.net.cn/sjb/xxgk/hysj/jjsj/202603/t20260326_81468.html

  2. 中国证券业协会从业人员管理系统 2025 年 12 月底数据(观点网转载),https://www.163.com/dy/article/KKCCRJ470519D45U.html

  3. 上海证券报:2025 年证券业罚单大盘点(天天基金网转载),https://fund.eastmoney.com/a/202601053608598053.html

  4. 新浪财经:广发证券辛治运:券商大力加强 AI 算力和知识库建设,https://finance.sina.com.cn/hy/hyjz/2025-09-13/doc-infqieur2077540.shtml

  5. 新浪财经:事关券商应用大模型,调研来了,https://finance.sina.com.cn/jjxw/2025-04-03/doc-inerwfmt2722313.shtml

  6. Patwardhan et al., GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks, arXiv:2510.04374, https://arxiv.org/abs/2510.04374

  7. 北京商报:方正证券研报乌龙!政策「时空穿越」,AI 幻觉不该背锅,https://www.bbtnews.com.cn/2026/0616/596483.shtml

  8. 科技日报:月之暗面发布新一代大模型 Kimi K3.1 Pro,https://www.stdaily.com/web/gdxw/2026-10/24/content_602239.html

证券行业的真实工作现状

截至 2025 年末,全国 150 家证券公司总资产 14.83 万亿元,全年营业收入 5,411.71 亿元、净利润 2,194.39 亿元[1];行业登记从业人员 36.87 万人,其中保荐代表人 8,526 人、证券分析师 6,109 人[2]。这个行业的日常工作,大多是在截止时点前把招股书、定期报告、合同条款、成交流水、研报和监管规则逐条核对清楚:投行写底稿、过内核,研究和投后拆财报、核验盈利预测,运营和财务做申赎确认、月结勾稽,风控盯偿债和退市风险。每个数字都要能追溯到来源,出错要追责:2025 年的高额罚单集中在投行业务,机构和直接责任人员同时受罚[3]。

AI 能给证券行业带来怎样的变化?

大模型已经进入券商一线流程。广发证券上线了流水核查、文档审核、债券底稿复核与自动生成等 56 项投行 AI 功能[4];深交所 2025 年的行业调研列出的场景还包括智能客服、投资决策支持、风险管理和智能投研[5]。这些场景处理的都是「读材料、对数字、写结论」,正是从业人员花时间最多的部分。

这种变化带来的真实价值有多大

OpenAI 的 GDPval 测评发现,前沿模型在 44 个职业的真实工作产出上已接近行业专家,有人监督时能做得更快、更便宜[6]。但证券行业对错误的容忍度很低:2026 年 6 月,方正证券一份周报把 2024 年的国常会表述标成 2026 年的最新部署,业内评价是「AI 仅是工具,最终责任必须由签字分析师与机构承担」[7]。所以 AI 在这里的价值,要看关键数字和口径算得对不对,而不是报告写得像不像。

现在的 AI 能否支撑真实工作场景的需要

这个问题还没有答案。公开榜单大多测问答和代码;GDPval 测的是美国职业和英文材料,不涉及中国的监管规则、中文资料包和信息截止时点。月之暗面 2026 年 10 月发布的 Kimi K3.1 Pro 宣称金融研究和长程 Agent 能力明显提升[8],这需要用真实工作来检验。

基于真实工作场景的测评报告

我们用 10 道按证券一线岗位真实委托设计的交付题,对比 Kimi K3.1 Pro 和上一代 Kimi K3。

测评介绍

  • 题目:每题给出角色、读者、截止时点和交付要求,附 5–12 份材料,模型需自己读材料、建模型,交付可打开的 Excel / Word 文件。题面要求 4 小时内完成(图 5 中的「题面预算」,对应真实工作的交付时限);沙箱运行超过 7 小时会被强制终止。

  • 运行:两个模型使用同一 Agent 框架(Claude Code)和同一沙箱,每题跑 1 次;非模型原因的失败最多重跑 2 次。

  • 评分:每题 28–40 条评分细则,覆盖结果正确性、专业质量、指令遵循、格式、语气,分关键项、重要项、加分项三档,另有一票否决项。裁判模型 gpt-5.6-sol 打开交付文件逐条判定,折算为 0–100 分。同一套题另有 opus-5、gpt-5.6-sol、seed 的参考分,裁判和公式相同。

  • 未交付:ETF 联接基金一题,Kimi K3 共运行 3 次:前 2 次执行超时、按规则重跑,第 3 次跑了 63 分钟、62 轮,仍没有写出任何交付文件,记 0 分;Kimi K3.1 Pro 得 55.8 分。为保持同题可比,下文均分按两边都有交付的 9 题计算;算上这一题,10 题均分为 31.5 → 47.0。

覆盖了哪些真实工作场景

工作场景 交付对象 交付物
定增认购评估与报价授权 投委会 测算表 + 决策备忘
经纪业务佣金收入月结复核 财务负责人 月结报告 + 四表台账
*ST 持仓标的退市风险复核 风险总监、投决会 测算表 + 复核报告
IPO 内核前质控复核 项目负责人、内核 复核明细 + 验收意见
永续策略账户网格配置复核 投委会 四表配置表
理财产品流动性压力测试 管理层 含看板和证据索引的工作簿
Pre-IPO 可研报告风险章节复核 风险管理部、投决会 修订稿 + 六表底稿
ETF 联接基金投资价值分析 投资决策者 分析报告
子公司参与基金出资请示 公司决策层 请示
矿业龙头半年报后投资逻辑复核 基金经理、风控 备忘录 + 计算底稿

这些题共同要求:遵守信息截止时点,核对多来源记录的冲突,缺的数据标「待补」不得编造,Excel 用公式、Word 数字可追溯且两份文件一致,并给出明确结论。

综合能力是否增强

增强了,但不稳定。在两边都有交付的 9 题上,Kimi K3.1 Pro 的平均分从 35.0 提高到 46.0,7 题领先、2 题落后;关键项满足率只从 55% 提高到 58%,9 题里只有 5 题更高。

各工作场景得分与关键项满足率
图 1 各工作场景得分与关键项满足率
同题得分对比
图 2 同题得分对比(右侧为 K3.1 Pro − K3)

按维度看,格式从 71% 提到 93%,关键项只从 51% 提到 54%。K3.1 Pro 把该做的事做得更全了,但把关键数字算对这件事改善不多。

检查项满足率:按维度与按重要程度
图 3 检查项满足率:按维度与按重要程度

哪方面强,哪方面弱

强项是以依据为主的文书。 出资请示(70.3 分)和佣金月结(68.8 分)都提高了 30 分以上,也是五个模型在这套题上的最高两分。出资请示一题,K3.1 Pro 把公司披露和研报观点分层引用,把不确定的承诺衔接列为待核查,关键项全部满足。网格配置和 Pre-IPO 两题,它补上了逐行去重依据、缺数据标的的披露和盈利预测兑现率检验。

弱项是多条件筛选后再汇总的计算和规则细节。 理财流动性一题退步 25.7 分,原因是少筛了一个维度;定增一题的档位累计规则两代都没处理对。矿业龙头一题 K3.1 Pro 多得 13.5 分,关键项满足率却从 55% 降到 45%,多出的分来自格式和加分项。

失分归因:五类典型错误

1. 中间结果未传递至最终交付物。 矿业龙头一题,两个模型的底稿都算对了矿山产银毛利(2026H1 26.28 亿元、2025H1 8.27 亿元),但 K3 的备忘录没提,K3.1 Pro 只写了增量 18.01 亿元,都判不满足。这类问题每题有 4–15 条。

2. 取数筛选条件缺失,错误沿计算链向下游传导。 理财流动性一题,可用现金应只计托管活期和清算备付账户中「可用且已入账」的资金。K3 筛对了,得到 7,867.10 万元;K3.1 Pro 漏了账户类型,把受限保证金和待交收资金也算进去,得到 16,554.58 万元,缺口、覆盖率、回购额度三条关键项连带失败。

3. 多记录取数口径错误:重复累加或误用取值规则。 定增一题,邀请书规定申购金额取有效档位的最大累计额,K3 把 5,000 万元和 3,000 万元相加成 8,000 万元,K3.1 Pro 把 5,000 万元写成 3,000 万元。理财题同一资产的多条询价,两代都做了重复累加。

4. 数值精度与一致性判断错误。 IPO 质控一题,11,525.5 ÷ 29,142.7 = 39.5485%,应为 39.5%,两个模型都写成 39.6%,并据此认定「与披露值一致」。

5. 引用来源与所引数值不符。 K3.1 Pro「写了不该写的内容」从 8 次降到 6 次,但出现了更隐蔽的错误:Pre-IPO 一题它注明引自某附件第 03 表,写的控制比例是 31.9348%,源表是 32.5811496%。这类错误比没给出处更难被复核的人发现。

跟其他模型比起来怎么样

两代 Kimi 与三份参考分逐题对比
图 4 两代 Kimi 与三份参考分逐题对比

按两边都有交付的 9 题计,K3.1 Pro 均分 46.0,与 opus-5(46.7)基本持平,高于 gpt-5.6-sol(43.4)和 seed(40.2);K3(35.0)低于三份参考分。但五个模型均分都没超过 47 分,目前没有一个模型的交付物可以不经复核直接使用。参考分是单次运行结果,且裁判 gpt-5.6-sol 本身也在被对照之列,数字适合看方向。

耗时与成本如何

指标(10 题合计) Kimi K3 Kimi K3.1 Pro
平均每题耗时 32 分钟 68 分钟(约 2.1 倍)
输入 token 合计 17.9M 35.4M(约 2.0 倍)
缓存命中率 88% 83%
成本合计 $107 $156(约 1.5 倍)
每 1 分的成本(10 题) $0.34 $0.33
每 1 分的成本(两边都有交付的 9 题) $0.29 $0.33
每题耗时与输入 token
图 5 每题耗时与输入 token

图 5 中橙色虚线是题面要求的 4 小时完成时限,红色虚线是沙箱 7 小时的强制终止线。20 次运行都在 4 小时以内结束。

每题成本(按实际 token 计算)
图 6 每题成本(按实际 token 计算)

成本 = 每题实际 token 用量 × 单价,10 题合计(含 ETF 一题);token 用量取自评测执行记录,分未命中输入、缓存读取、缓存写入、输出四类。单价(美元 / 百万 token):K3 输入 20、缓存读取 2、输出 100;K3.1 Pro 输入 13、缓存读取 1.3、输出 68;缓存写入按输入单价计。

K3.1 Pro 单价比 K3 低三成多,但输入 token 约 2 倍、输出约 1.8 倍,缓存命中率也更低,总成本约 1.5 倍。命中率的差别集中在个别题:K3 各题在 77%–91% 之间,K3.1 Pro 在 46%–90% 之间,最低的是 *ST 退市风险一题,1.7M 输入里只有 0.8M 走缓存,花了 $18.17。按每 1 分算,10 题合计两者持平,但 K3 的数字里有 ETF 一题花掉、没换来交付的 $15.34;只看两边都有交付的 9 题,K3.1 Pro 每分贵约一成。所有题都在题面要求的 4 小时内完成,最长的是 K3.1 Pro 做矿业龙头一题,158 分钟、$35.58。

总结:Kimi 的进步,与它对真实工作的支撑能力

  • 进步是真实的:平均高 11 分,均分与 opus-5 持平,以依据为主的文书拿到全场最高分,「金融研究能力提升」在这套题上能看到。

  • 进步主要在完整度:格式和加分项大幅提高,关键项几乎没动。筛选口径、规则适用、舍入这些决定结论对错的环节,两代模型错在同样的地方;K3.1 Pro 还出现了「出处具体但数字不对」的新风险。

  • 更慢、更贵:耗时约 2.1 倍,成本约 1.5 倍;只看两边都有交付的 9 题,每 1 分的成本 K3.1 Pro 高约一成。

  • 离直接交付还有距离:五个模型均分都不到 47 分。现阶段适合让模型做初稿、搭底稿、梳材料,人工重点复核筛选条件是否完整、多条记录的取数规则、底稿数字是否写进报告、舍入判断,以及出处与数字是否对应。

局限:每题只跑 1 次,单次得分波动较大,结论应看方向;ETF 一题 K3 三次运行均未交付,同题比较按两边都有交付的 9 题计;评分来自大模型裁判;参考分的运行条件可能与本次不同。

前言数据来源

以下为第一部分「证券行业的真实工作现状」中行业规模、从业人数、罚单、券商 AI 应用、GDPval 测评和 Kimi K3.1 Pro 发布等事实的出处,对应正文方括号编号 [1]–[8]。测评数据来自本次实际运行记录,不在此列。

  1. 中国证券业协会:证券公司 2025 年度经营数据,https://www.sac.net.cn/sjb/xxgk/hysj/jjsj/202603/t20260326_81468.html

  2. 中国证券业协会从业人员管理系统 2025 年 12 月底数据(观点网转载),https://www.163.com/dy/article/KKCCRJ470519D45U.html

  3. 上海证券报:2025 年证券业罚单大盘点(天天基金网转载),https://fund.eastmoney.com/a/202601053608598053.html

  4. 新浪财经:广发证券辛治运:券商大力加强 AI 算力和知识库建设,https://finance.sina.com.cn/hy/hyjz/2025-09-13/doc-infqieur2077540.shtml

  5. 新浪财经:事关券商应用大模型,调研来了,https://finance.sina.com.cn/jjxw/2025-04-03/doc-inerwfmt2722313.shtml

  6. Patwardhan et al., GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks, arXiv:2510.04374, https://arxiv.org/abs/2510.04374

  7. 北京商报:方正证券研报乌龙!政策「时空穿越」,AI 幻觉不该背锅,https://www.bbtnews.com.cn/2026/0616/596483.shtml

  8. 科技日报:月之暗面发布新一代大模型 Kimi K3.1 Pro,https://www.stdaily.com/web/gdxw/2026-10/24/content_602239.html

返回

更多博客